Doubao Seedance 2.5 提示词指南--火山方舟-火山引擎.md33.1 KBit/ai/Doubao Seedance 2.5 提示词指南--火山方舟-火山引擎.md
--- title: "Doubao Seedance 2.5 提示词指南--火山方舟-火山引擎" source_url: "https://docs.volcengine.com/docs/82379/2607689?lang=zh" source_site: "docs.volcengine.com" clipped_at: "2026-08-10T11:02:51.908815+00:00" clipper: "aiwiki-url-ingest" extractor: "readability_rendered" source_strategy: "normal_web_clip" source_strategy_label: "普通网页抓取" --- # Doubao Seedance 2.5 提示词指南--火山方舟-火山引擎 本文介绍 Doubao Seedance 2\.5(下文简称 Seedance 2\.5)模型的提示词(Prompt)使用方法和相关技巧,帮助您更高效地利用该模型生成符合需求的优质视频作品。 强烈推荐使用 Seedance 2\.5 skill 对您的提示词进行调优。 - npx \-\-yes skills@latest add \\ "https://arkdocs.tos\-cn\-beijing.volces.com/skills/" \\ 2. 使用方式:在 AI 对话框输入 /sd25\-pe \+ 你的提示词内容,开始调试提示词。 Seedance 2\.5 模型支持单段 30 秒视频直出 ,单次可输入图像/音频/视频 最多 50 个参考素材 ,具备更强的指令控制,专业级可控的 视频编辑与延长 能力;同时,原生支持生成 10 余种语言 ,保障专业级叙事在全球化场景中稳定落地,让视频生成迈入「 长叙事 × 强参考 × 准编辑 × 多语言 」的工业级新阶段。 模型创作能力持续深化,画面 真实感 显著增强,在 光影表现 、 表演理解与执行 、 镜头运动 上都更 接近真实拍摄 ,成片质感与叙事可信度大幅提升,为专业创作者与企业客户提供更高效、更可控的视频生产能力。 Seedance 2\.5 支持文本、图片、视频和音频等多模态输入的灵活组合。下表仅列举部分典型能力,更多使用方式可根据实际场景进行探索。 Seedance 2\.5 从传入素材最终是否会锁定输出视频的属性,把任务区分为两类(Seedance 2\.0 没有这个区分): - 有锁定:素材会严格成为输出视频时间轴上的一段,是模型输出去适应传入的素材,因此会锁定输出视频的宽高比、甚至时长。 - 无锁定:仅对素材进行语义上的参考,因此用户可以指定输出视频的宽高/时长属性。 编辑/首尾帧/延长会根据输入素材自动锁定部分生成参数,不支持用户自定义。具体规则如下: 参考类任务对于输出视频的宽高比和时长没有来自输入素材的锁定,特别注意以下两类任务也是没有锁定的: Seedance 2\.5 单次可输入图像/音频/视频 最多 50 个参考素材 ,这些素材可能指向的是同一个或者不同的主体(人物、动物、道具、场所等)。为了充分激发模型的能力,对素材的输入有以下建议: 把 Seedance 2\.5 当作一个视觉内容生产者,用导演的思维书写 \[ 结构化 Prompt ]。 (R2V)素材指代 明确每个图/视频/音频的编号(按照上传顺序)与用途(谁是形象、谁是音色、谁是动作、谁是场景...)。 一句话概述 主体 \+ 地点 \+ 事件 \+ 题材/风格 \+ 特殊运镜... 具体情节描述 镜头顺序/时间轴(均可):用时间戳或「镜头 N」切分,逐段描述画面具体内容、运镜、动作、台词、音效等,尽量使用正向描述。 反向描述支持:字幕、音频控制,比如「不要字幕」、「不要 bgm」。 结尾 补充说明一些贯穿始终的画面细节,比如机位/运镜,环境/场景,声音,氛围等。 写实自然纪录片风格,电影级真实光影,温暖的午后, 在森林草坡上, 一只圆滚滚的熊猫幼崽从坡上滚下来. 熊猫黑白毛发蓬松真实,体型小而胖,动作笨拙可爱。场景为绿色森林斜坡,地面覆盖青草、苔藓、三叶草、泥土、小石块、枯枝和少量小黄花,虚化背景中有高大树干与树林。镜头为低机位中远景,轻微手持感,整体基本固定,始终保持熊猫在画面中。 0s\-3s:一只熊猫幼崽趴在绿色草坡上,身体圆滚滚, 它刚开始顺着斜坡慢慢侧滚,动作笨拙,草叶被身体轻轻压弯。微风拂过, 阳光从左上方穿过树林,形成斑驳光影。 3s\-8s:熊猫滚到画面右下方,动作逐渐停止,从侧躺变成趴卧。它的圆脸朝向镜头,前爪压在草地上,熊猫趴在前景草丛中,身体调整到舒服的姿势,头部小幅抬起又放低, 发出轻微哼唧声。 低机位,轻微手持感,轻微跟随熊猫向右下方移动。景深自然,前景草叶轻微虚化,熊猫主体清晰,背景树林柔和虚化。自然环境音,风声、熊猫滚动时轻微柔软的扑通声, 整体温暖、真实、自然。 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 参考素材变多后, 素材的映射和指代关系说明非常重要 。按照上传素材的顺序对应编号(图 1 / 视频 1 / 音频 1),每个素材进行文本绑定, 不建议只在图片里呈现映射信息 ,比如主角图片上写「张三」,然后 Prompt 中直接写「张三在学校里 xxxx」,容易导致多人混淆或重复角色。 - 多主体逐一列清映射关系,人数多时用清单罗列,避免混淆。 - 示例 2:「img1\-2 是人物 1,对应音频 1;img3\-4 是人物 2,对应音频 2」 - 示例 3:「图片 1 是主角张三,图片 1 使用音频 1 音色」 - 分工要具体到「参考什么」,如果是部分参考,要写明「参考哪一部分」。 - 示例 1:「参考视频 1 中施法的动作,视频 2 的环绕式运镜」 - 当参考素材本身已足够精准时,建议只做「指代」、减少画面复述。 - 示例:「严格参考视频 1 的动作与运镜,顺序与视频保持一致」(不需要在 prompt 中写「先抬手、再转身、镜头缓慢环绕……」等等具体细节,不必额外描述) 明确需要修改的范围和内容,可以配合时间戳进行部分编辑,尽可能说明修改内容从 A\-\>B 的过程。 - 示例 1:「仅编辑视频 1 中男人的台词,修改为「你不要过来啊」,口音调整为东北口音…」 - 示例 2:「把视频 1 中 4\-6 秒男人喝咖啡的动作改变为拖地,其余内容不要变化」 - 示例 3:「编辑任务:把视频 1 中右侧的亚洲女生改为图片 1 中的黑人女生」 - 优先使用参数设置图片的role为:first\_frame/last\_frame; 注意此方式会锁定输出视频的宽高比,严格对齐用户输入视频的首帧图。 - 也支持设置 role 为 reference\_image,在 prompt 中指定具体图片为首帧\&尾帧。注意此方式不会锁定输出视频的宽高比,视频效果与首帧\&尾帧参考图相近,但不完全匹配。 - 示例 2:「图片 3 为首帧,图片 5 为尾帧」 时间戳可以更好地理清故事剧情发展,以「1 秒」为单位: - 指定时间段内剧情如果较少,模型会进行一定自由发挥。 - 指定时间段内容过多,则会导致过度剪切或剧情遗漏,请注意时长安排的合理性。 - 不建议用时间戳控制频率/频次,比如「一秒摇头 3 次」。 支持的时间控制方式: - 明确的时间区间 \[注意时间轴的连续性,避免出现「0\-3 秒...5\-6 秒...」表达]。 - 示例 1:「0\-3 秒......3\-7 秒.....7\-15 秒」 - 示例 2:「\[1s\-4s]....\[4s\-8s]....\[8s\-12s]」 - 示例 2:「第 2 秒一道金雷能量自画面顶部破空直落...」 - 示例 1:「张三呆滞的站在原地,3 秒后周围的人纷纷摇头」 - 示例 2:「....主角按下快门后画面定格 1 秒」 - 支持负向控制音频:支持更细维度的单独控制:音效、背景音乐(bgm)、对白。 - 基础的通识性内容可以直接写,比如景别(大全景/全景/中景/近景/特写)、运镜(推/拉/摇/移/跟/环绕/俯冲/后拉/上摇/手持晃动)、机位(低角度/俯视/第一人称)。 - 热门的运镜方式可以直接写,比如一镜到底、希区柯克变焦、航拍视角、FPV、子弹时间、手持镜头、回弹变速等。 - 过于小众、专业的名词需要转换为 \[名词 \+ 描述性解释]。 - 示例:「移焦,画面焦点发生平滑转变,原本在前景清晰的树木变模糊,背景中的人物由模糊逐渐变得清晰。」 - 转场镜头写清触发点与方式,尽可能把转场时间、方式都写明。 - 示例:「第 5s 快速向左横移转场(向左擦除\+自然叠化)」 - 动作 :优先用概括性描述(如「连续做了几组高抬腿和空翻」「双方展开近身搏斗」),只在少数有记忆点的动作上写出具体细节,不建议重复写相同的动作。 - 表情 :建议写描述性语句,减少成语使用,比如「津津有味地吃饭」写为「脸上带着满足的笑容,大口地吃饭」。 - 示例 1:白模中没有光影变化,只希望参考运镜和运动 → 「参考 \[视频 1] 的运镜、动作...」 - 示例 2:白模有光影变化且需要参考 → 「参考 \[视频 1] 的光影变化和...」 - 如果叠加输入了参考图,需写明参考图和白模的对应关系。 - 示例:「将 \[图片 1] 中穿灰色衣服的男人对应 \[视频 1] 中的红色模型、\[视频 2] 中的红发少女替换 \[视频 1] 中的绿色模型 2」 - 输入了白模视频,也 建议在 Prompt 中详细描述希望生成的视频内容 ,以获得更好的效果,并且注意文本描述需要和白模内容相吻合;对于没有叠加参考图/视频的白模主体,详细描述主体外表/特征效果更佳。 - 减少超多分镜输入 :多宫格目前更适用于 15 个以下分镜 ,单次输入过多(比如 18 宫格)容易出现静止、顺序错乱等问题,同时分镜图会限制模型发挥,请确保分镜准确、合理。 - 避免脏/锐化的分镜图 :不推荐过度锐化、杂乱的 AI 直出分镜图;不推荐在分镜图上写过多文字。 - prompt 避免前后矛盾 :注意避免 prompt 前后矛盾或运镜、运动设计不合理等问题。 - 宫格图并不会严格对齐分镜内容 ,视频会有一定自主性发挥,如需严格按照分镜图生成时,推荐使用多关键帧参考方式。 - 火柴人/线稿分镜使用 \[推荐] :推荐使用相对简约的线稿分镜图,并通过 prompt 进行指令控制: - step3:按照分镜完整描述情节内容,至少补齐分镜图中没有的信息,可以考虑组合时间戳明确剧情逻辑 - 素材绑定:故事板分镜@图片1,卧室@图片2,李天@图片3,李倩@图片4,《快快乐乐》书籍@图片5。 【全景固定镜头,平视三分构图】冬夜落雪房间,落地窗前,男子双手插裤兜侧立望向窗外飞雪,少女站在身侧静静看向男子,氛围安静克制,雪花持续落在玻璃窗。 【中景过肩镜头】少女后背作为前景,男子转头温和看向少女,少女微微低头沉默,窗外落雪持续。 【中近景,对角线构图】男子捧着书籍《快快乐乐》缓缓递出,少女抬手接过书本。 【少女面部近景,中心构图】少女把书本抱紧在胸口,眼眶泛红,泪珠缓缓滑落,神色感伤。 【男子面部近景,斜向构图】男子温柔浅笑,静静注视落泪少女,眼底带着怅然。 【全景固定镜头】少女转身缓步走出画面,窗前只剩男子独自伫立,双手插兜望向漫天风雪,房间空旷寂静。 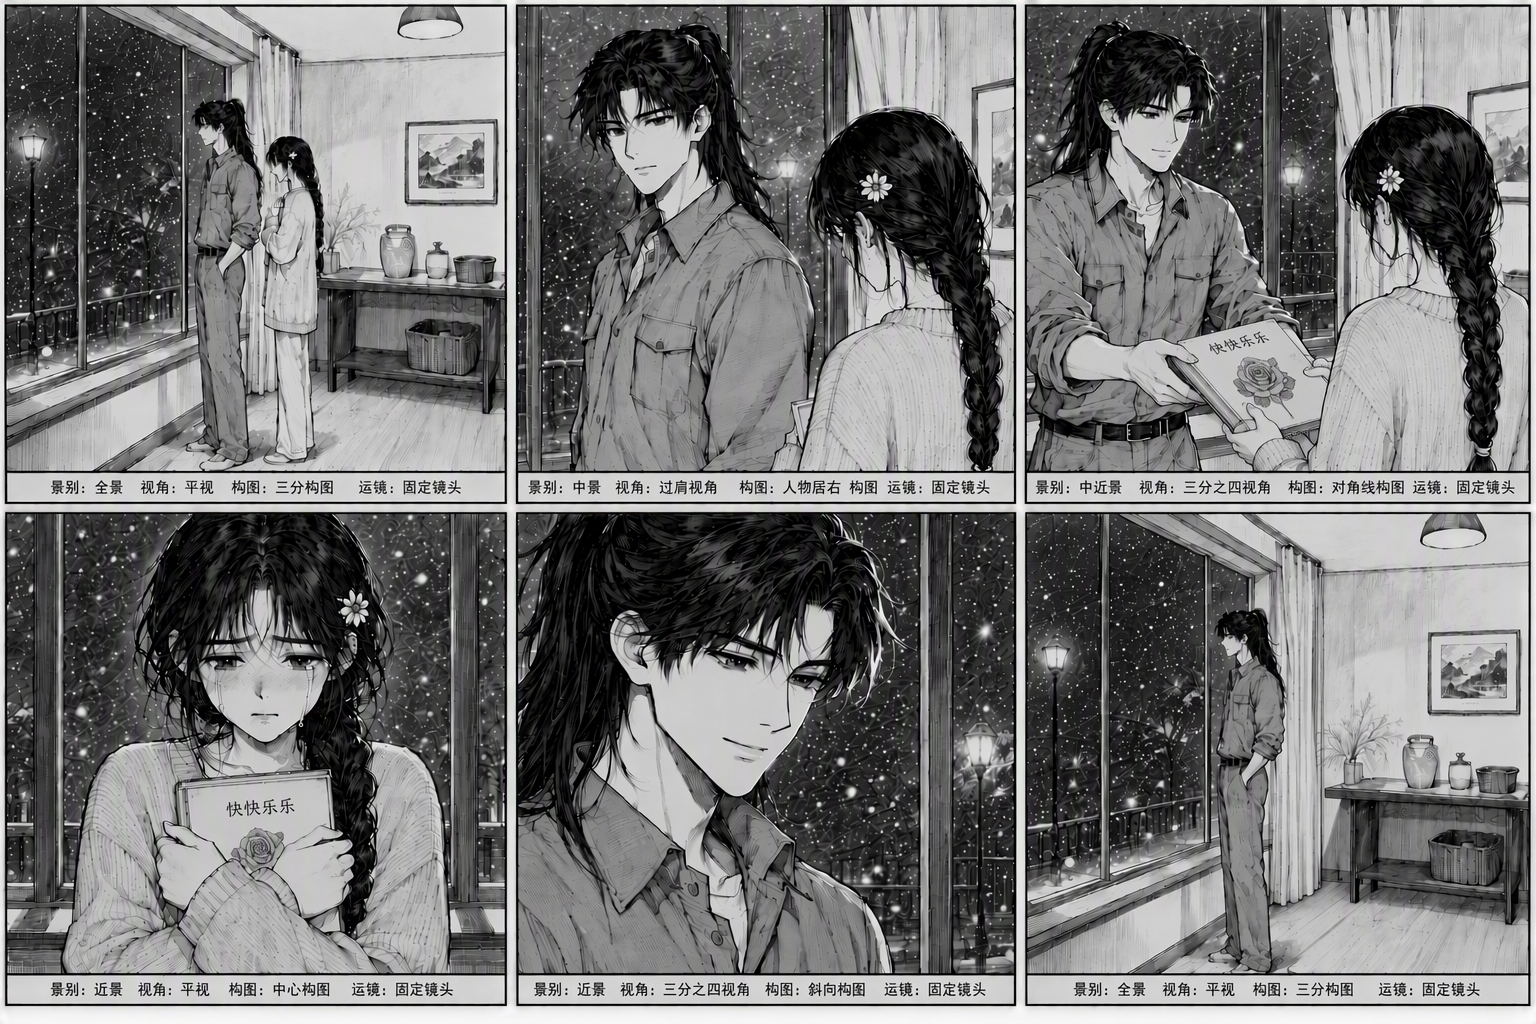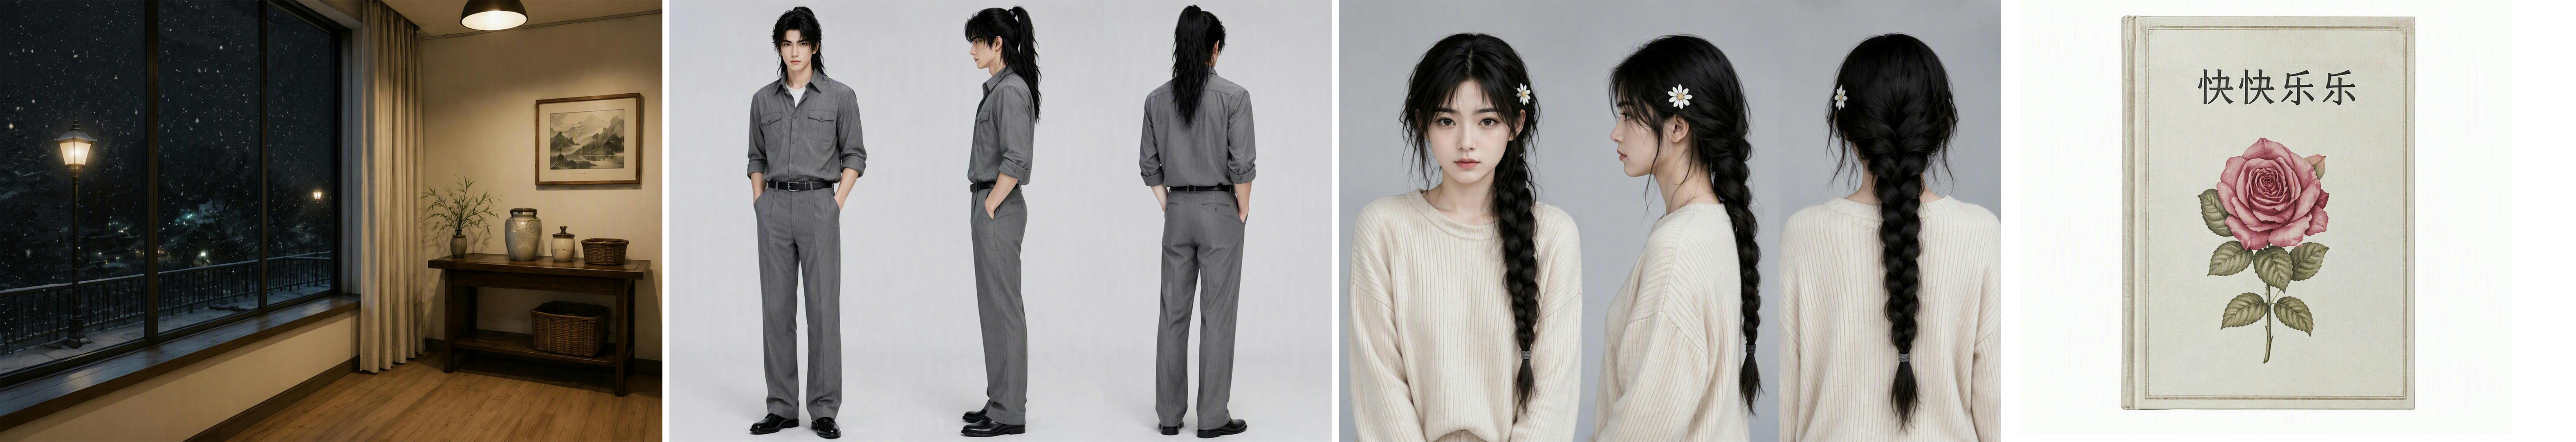 - 概念分镜使用 :如果分镜是概念分镜或关键帧设计,可以直接简写 prompt。 - 示例:「按照分镜图的顺序,构建一个完整的故事剧情,运镜合理连贯」 -  视频需要严格按照分镜图生成时使用,关键帧参考就是将分镜按照独立参考输入,并按照顺序传入,prompt 需要在第一句写明「以图片 x 至图片 x 的顺序作为关键帧」。 - 示例:「 以图片 1 至图片 7 的顺序作为关键帧 ,在云海群山间,蓝粉长尾灵鱼凌空遨游,镜头缓缓推向依山而建的古镇,聚焦山顶古塔;画面一转进入雅致中式厅堂,灵鱼穿窗飞入,落入厅堂中央圆池悠然游动;最终视角切至幽暗古寺,白须老僧背对而立,静静凝望巨幅画框,画内正是厅堂与池中灵鱼,新国风浮世绘插画风格」 1. 响应时间戳:Seedance 2\.0 不响应时间戳只响应镜头序号,而 Seedance 2\.5 响应整数秒的时间戳。 2. 支持多视图:Seedance 2\.0 不建议使用多视图作为主体参考,而 Seedance 2\.5 是可以支持的。 3. 自由宽高比:Seedance 2\.0 的输出宽高比只有固定的 6 档,Seedance 2\.5 可以通过控制输入素材的方式支持 \[0\.4, 2\.5] 之间的任意宽高比输出。 4. 提升 V2V 的画质:Seedance 2\.5 的输出支持 MOV 格式,在延长/编辑任务中更好地保持颜色与亮度一致性、声画一致性。 主体/运动/音频/风格参考的使用方式与 Seedance 2\.0 一致,可以参考 [附录:提示词案例](/docs/82379/2222480#ff5fb3e6),下文介绍 Seedance 2\.5 新增的参考能力。- 支持输入含有 运动、运镜、动线和光照 等动态/时序信息的白模视频进行渲染;还支持叠加输入 主体、场景和道具 等参考图控制渲染效果。 - 当前版本对于简单建模的参考效果较好,建议仅用 简单几何体 拼接表示人物/物体/动物等。 说明 白模视频主体建议仅保留躯体,避免包含【四肢/翅膀】等涉及精细运动的元素;如已包含,需补全其动作序列,以防止渲染结果出现四肢僵化。 白模类型:含切镜/运镜/光照 输入:文本 prompt:以白模参考视频 \<video1\> 作为整支视频唯一的运镜、镜头节奏、景别变化、主体运动轨迹和镜头调度参考,严格保持白模视频的镜头顺序、机位变化、运动方式和节奏,不改变镜头结构,不新增镜头,不改变主体运动逻辑。结合各阶段关键帧参考图,生成一部 30 秒电影级 3D 动画短片,整体风格梦幻、童话、温暖,具有儿童幻想色彩,角色外形与各阶段的关键帧保持一致,不要改变角色形象,人物表情情绪随场景变化而改变。 - 0\-3s(首帧参考 \<2pic\>)镜头由全景俯视缓缓推向地上的小女孩,小女孩坐在房间的地毯上玩飞机,小女孩起身左转,右手使劲一挥将手里的飞机放飞。 - 3\-5s(参考 \<3pic\>)飞机从左至右穿过房间悬挂的星星挂件,小女孩乘坐飞机进入幻想的天空。 - 5\-8s(参考 \<4pic\>)镜头继续侧跟,以小女孩为中心的环绕。 - 8\-10s(参考 \<5pic\>)镜头环绕到小女孩驾驶的飞机背面、飞机开始缓缓俯冲海面。 - 10\-19s(参考 \<6pic\>、参考 \<7pic\>)小女孩继续向海底游去,一条鳐鱼游过来入画。 - 19\-23s(参考 \<8pic\>)小女孩从时空裂缝冲出来到幻想宇宙。 - 23\-24s(参考 \<9pic\>)前景小女孩和星球开始前翻转并,逐渐幻化消失。 - 24\-28s(参考 \<9pic\>)俯视镜头持续推进,小女孩躺在地的毯上熟睡。 - 28\-30s(参考 \<10pic\>)镜头继续推进绘本,随后爸爸进入画面。 整体要求:所有画面均参考对应关键帧,白模视频仅作为运镜、镜头运动和角色动画参考,不参考画面内容。最终输出 30 秒 16:9 横构图宽屏视频。 输入:视频、图 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x video1 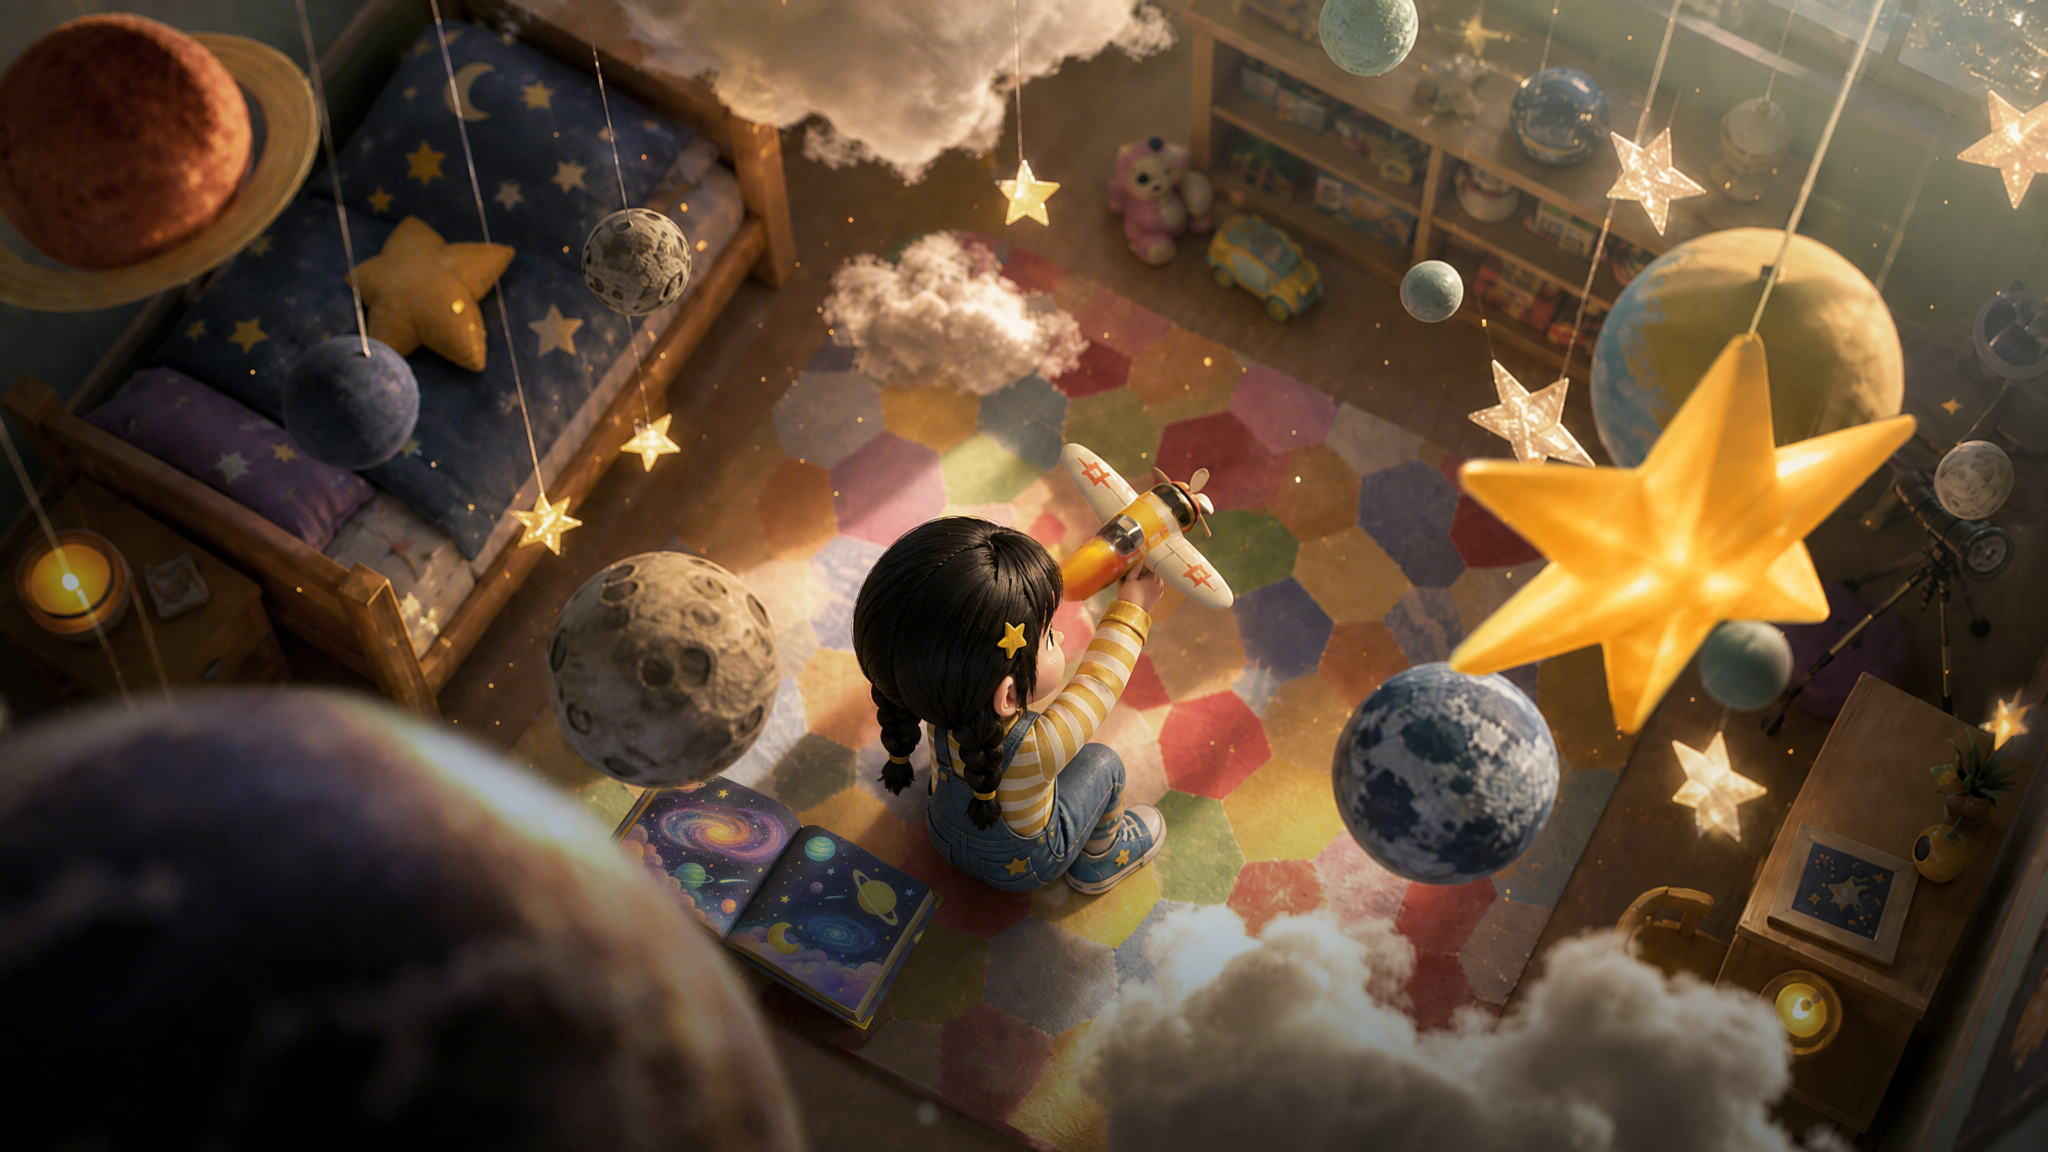2pic 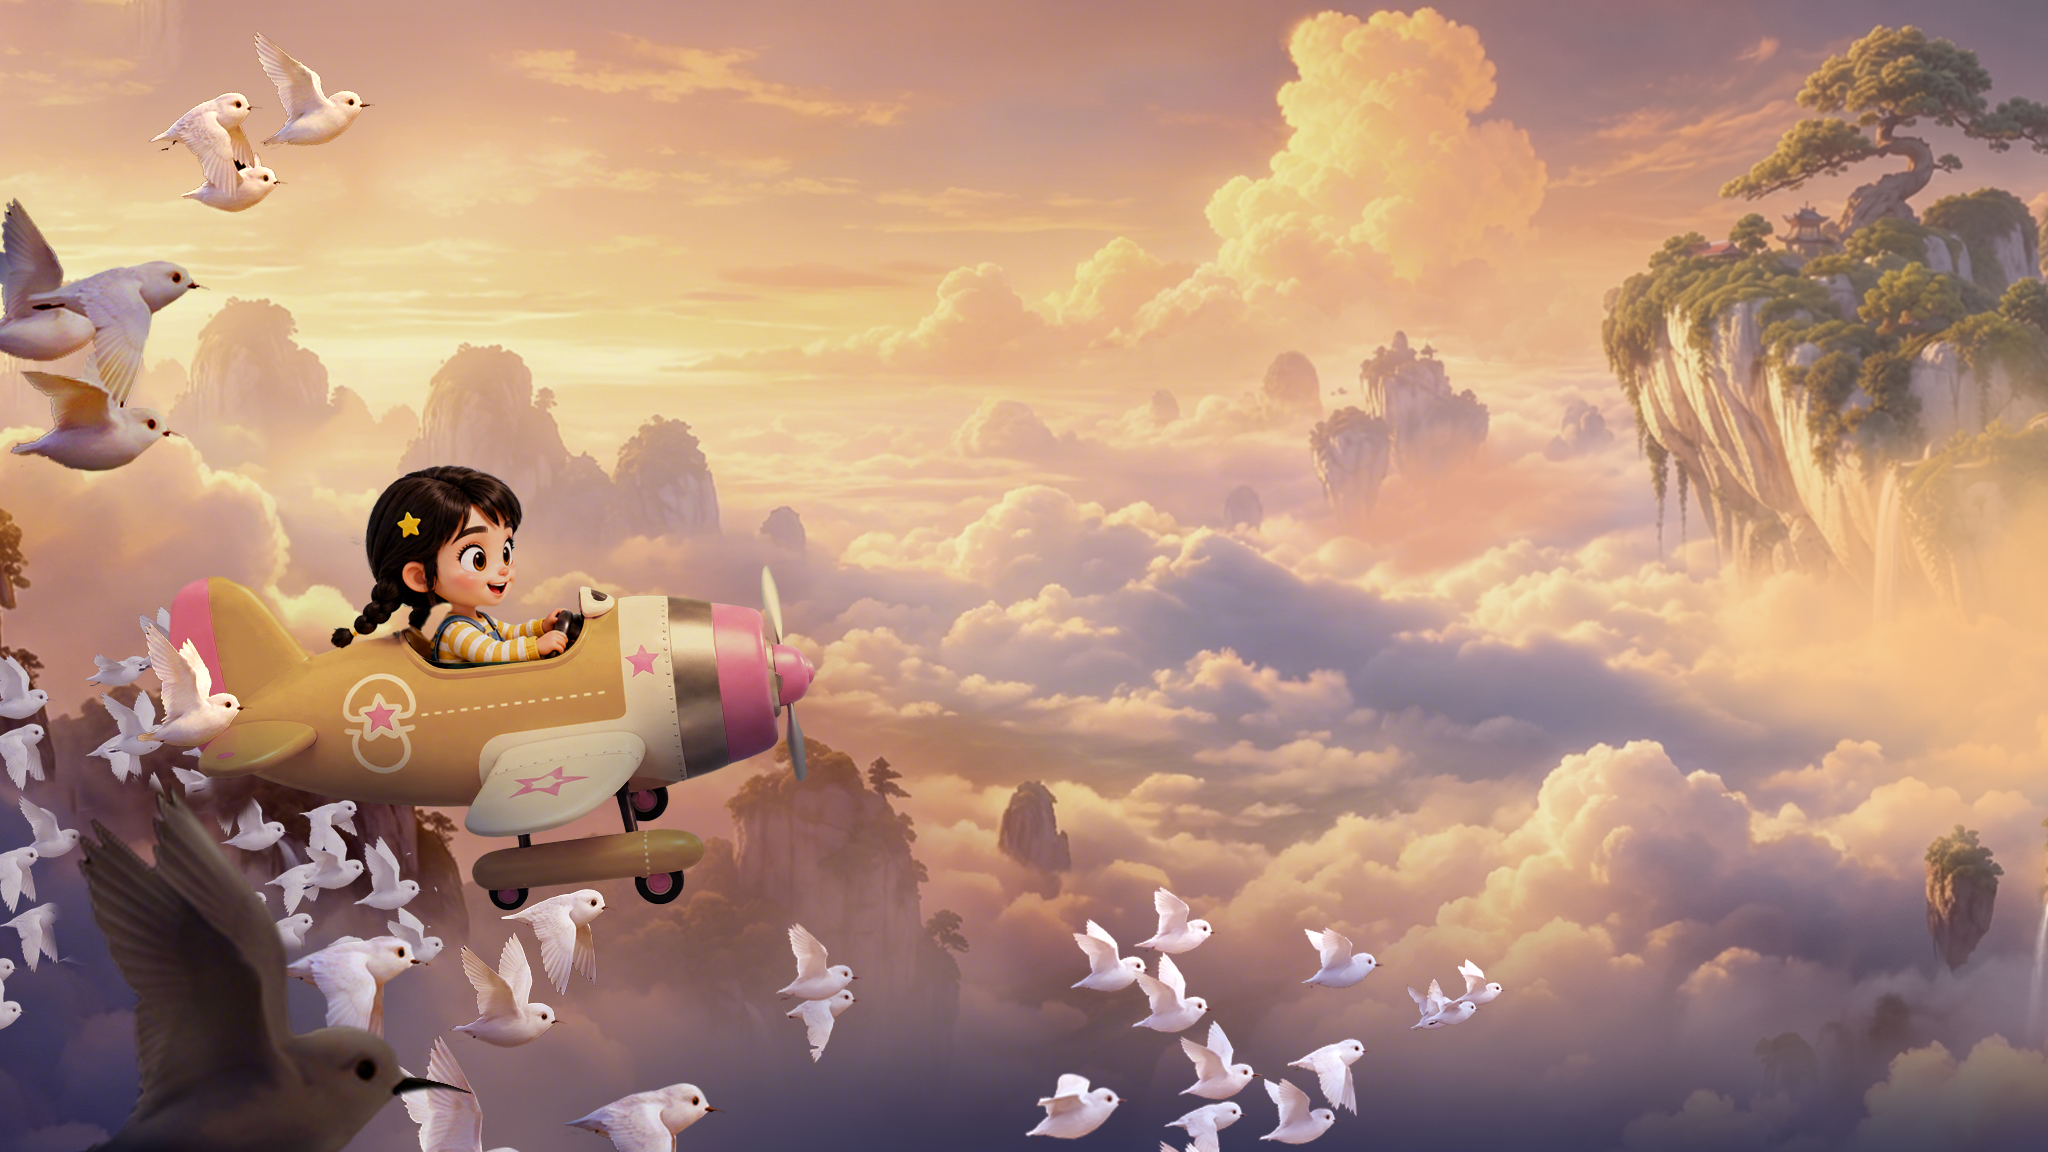3pic 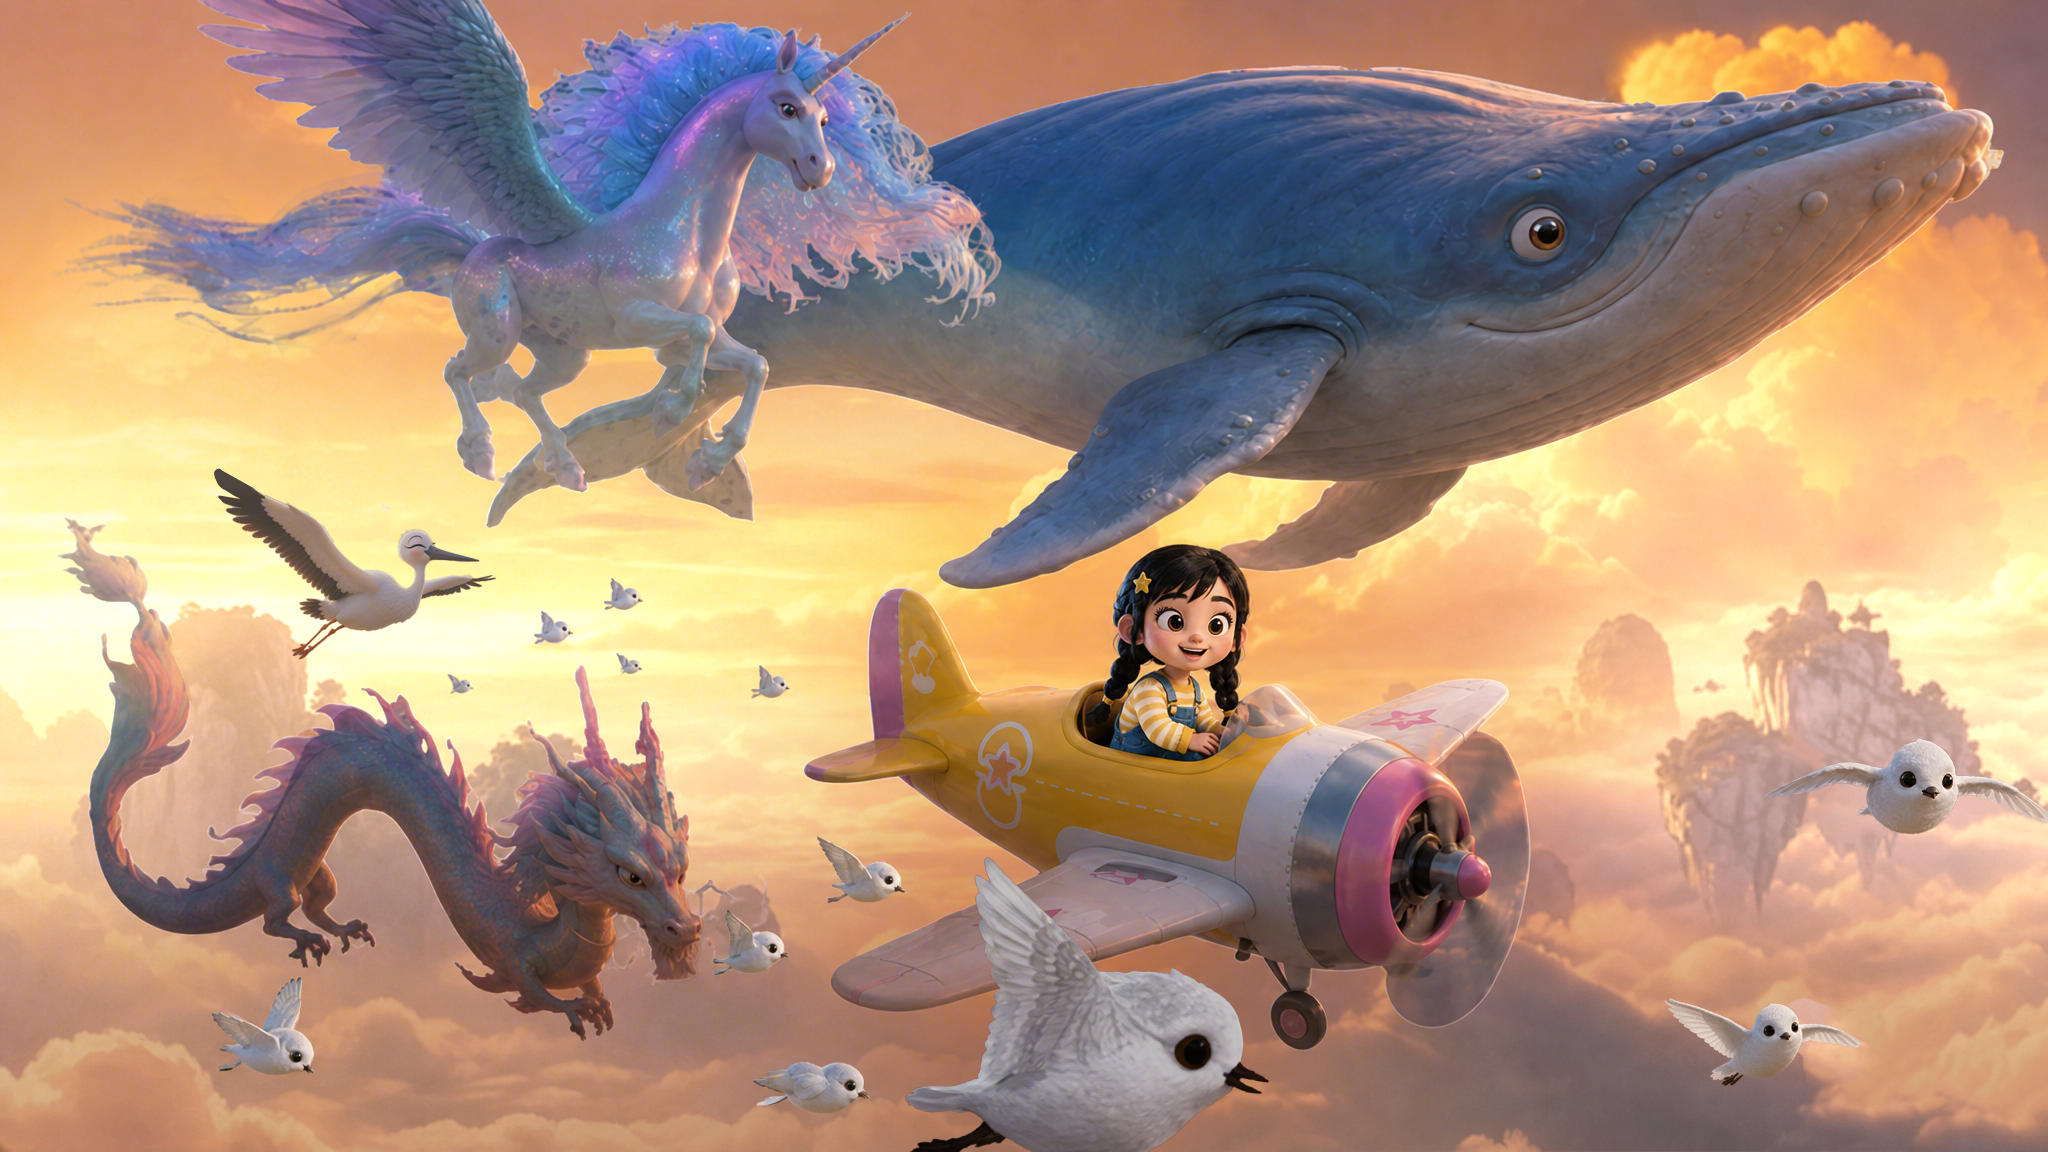4pic 5pic 输入:视频、图(续) 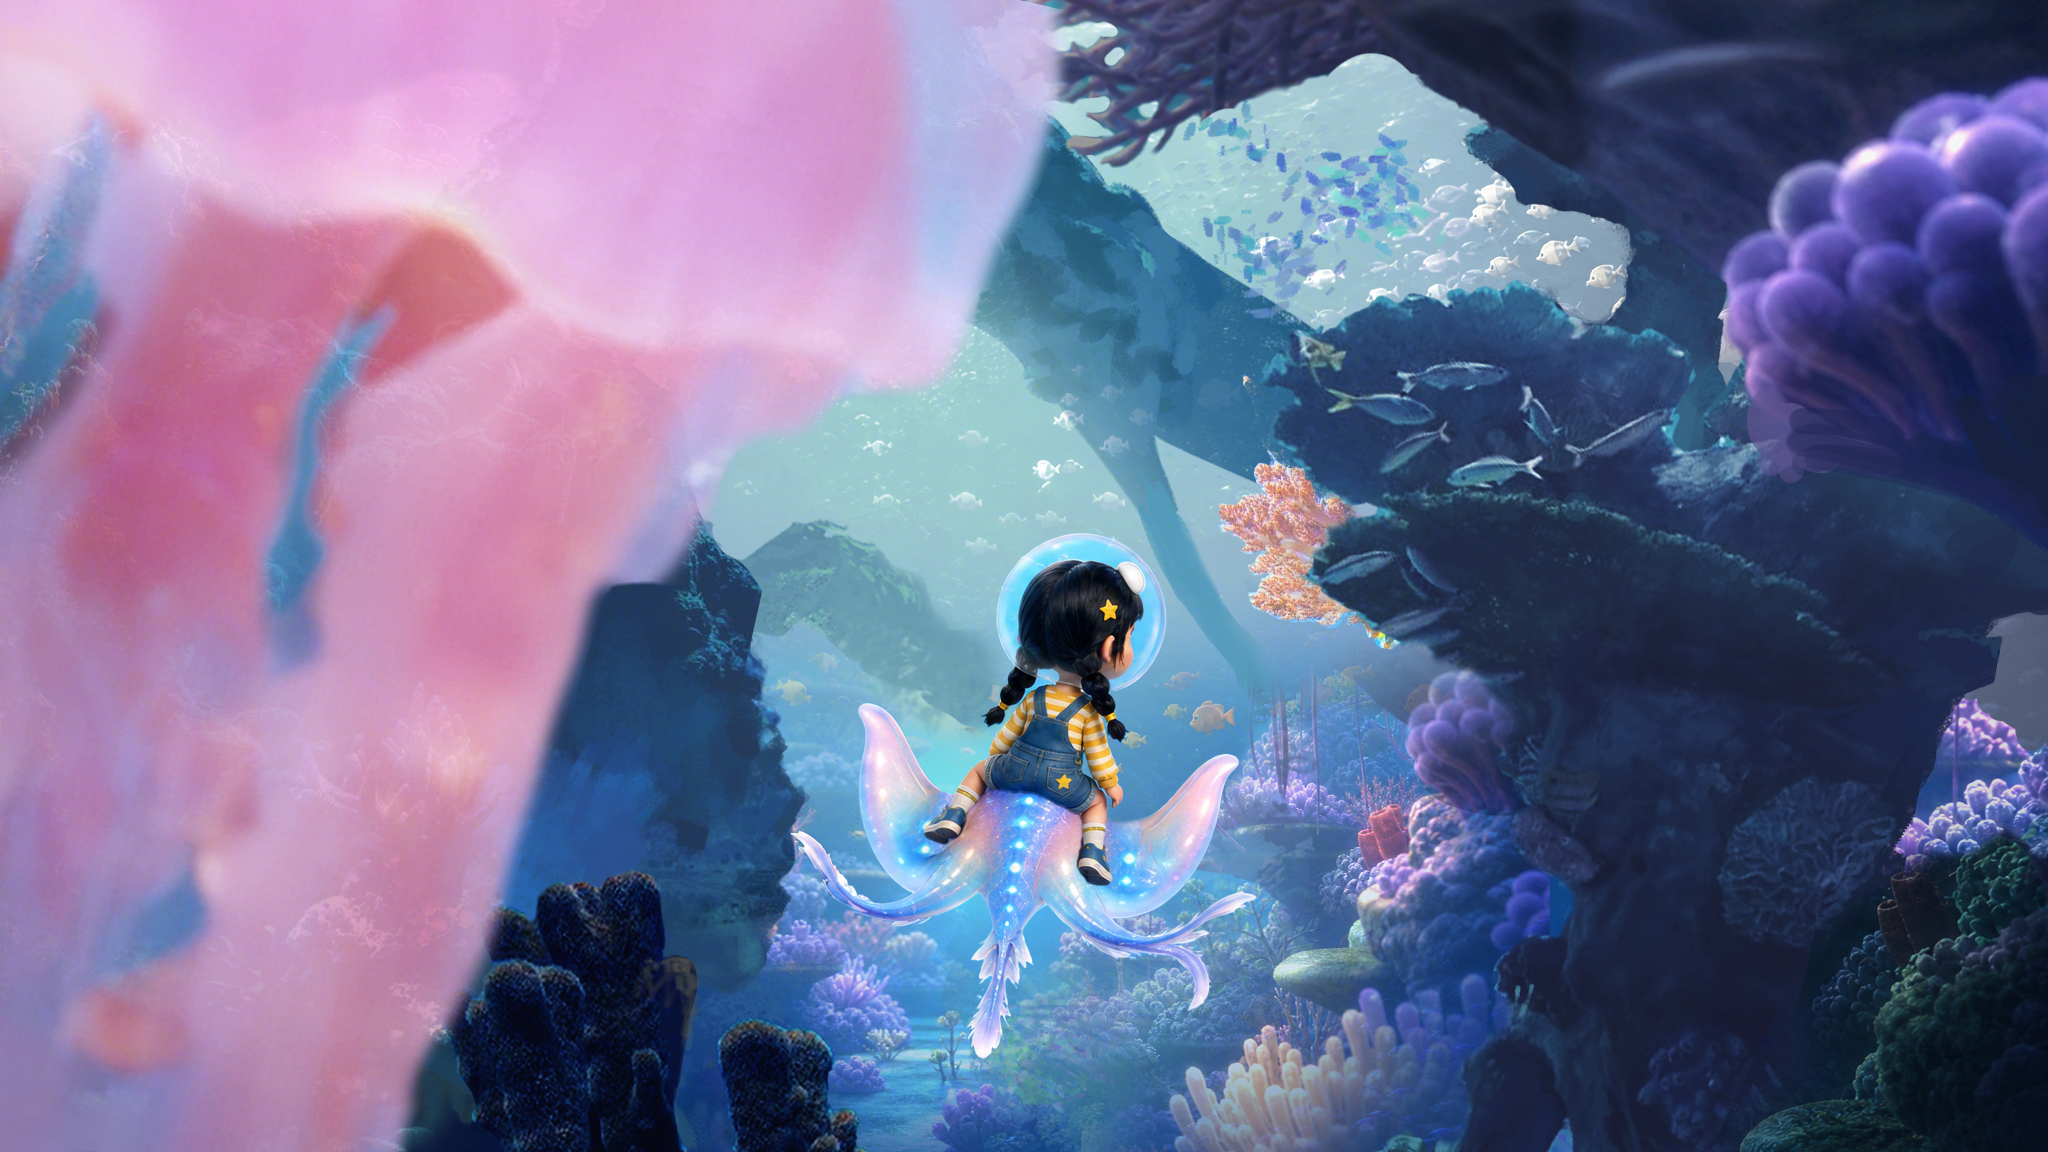6pic 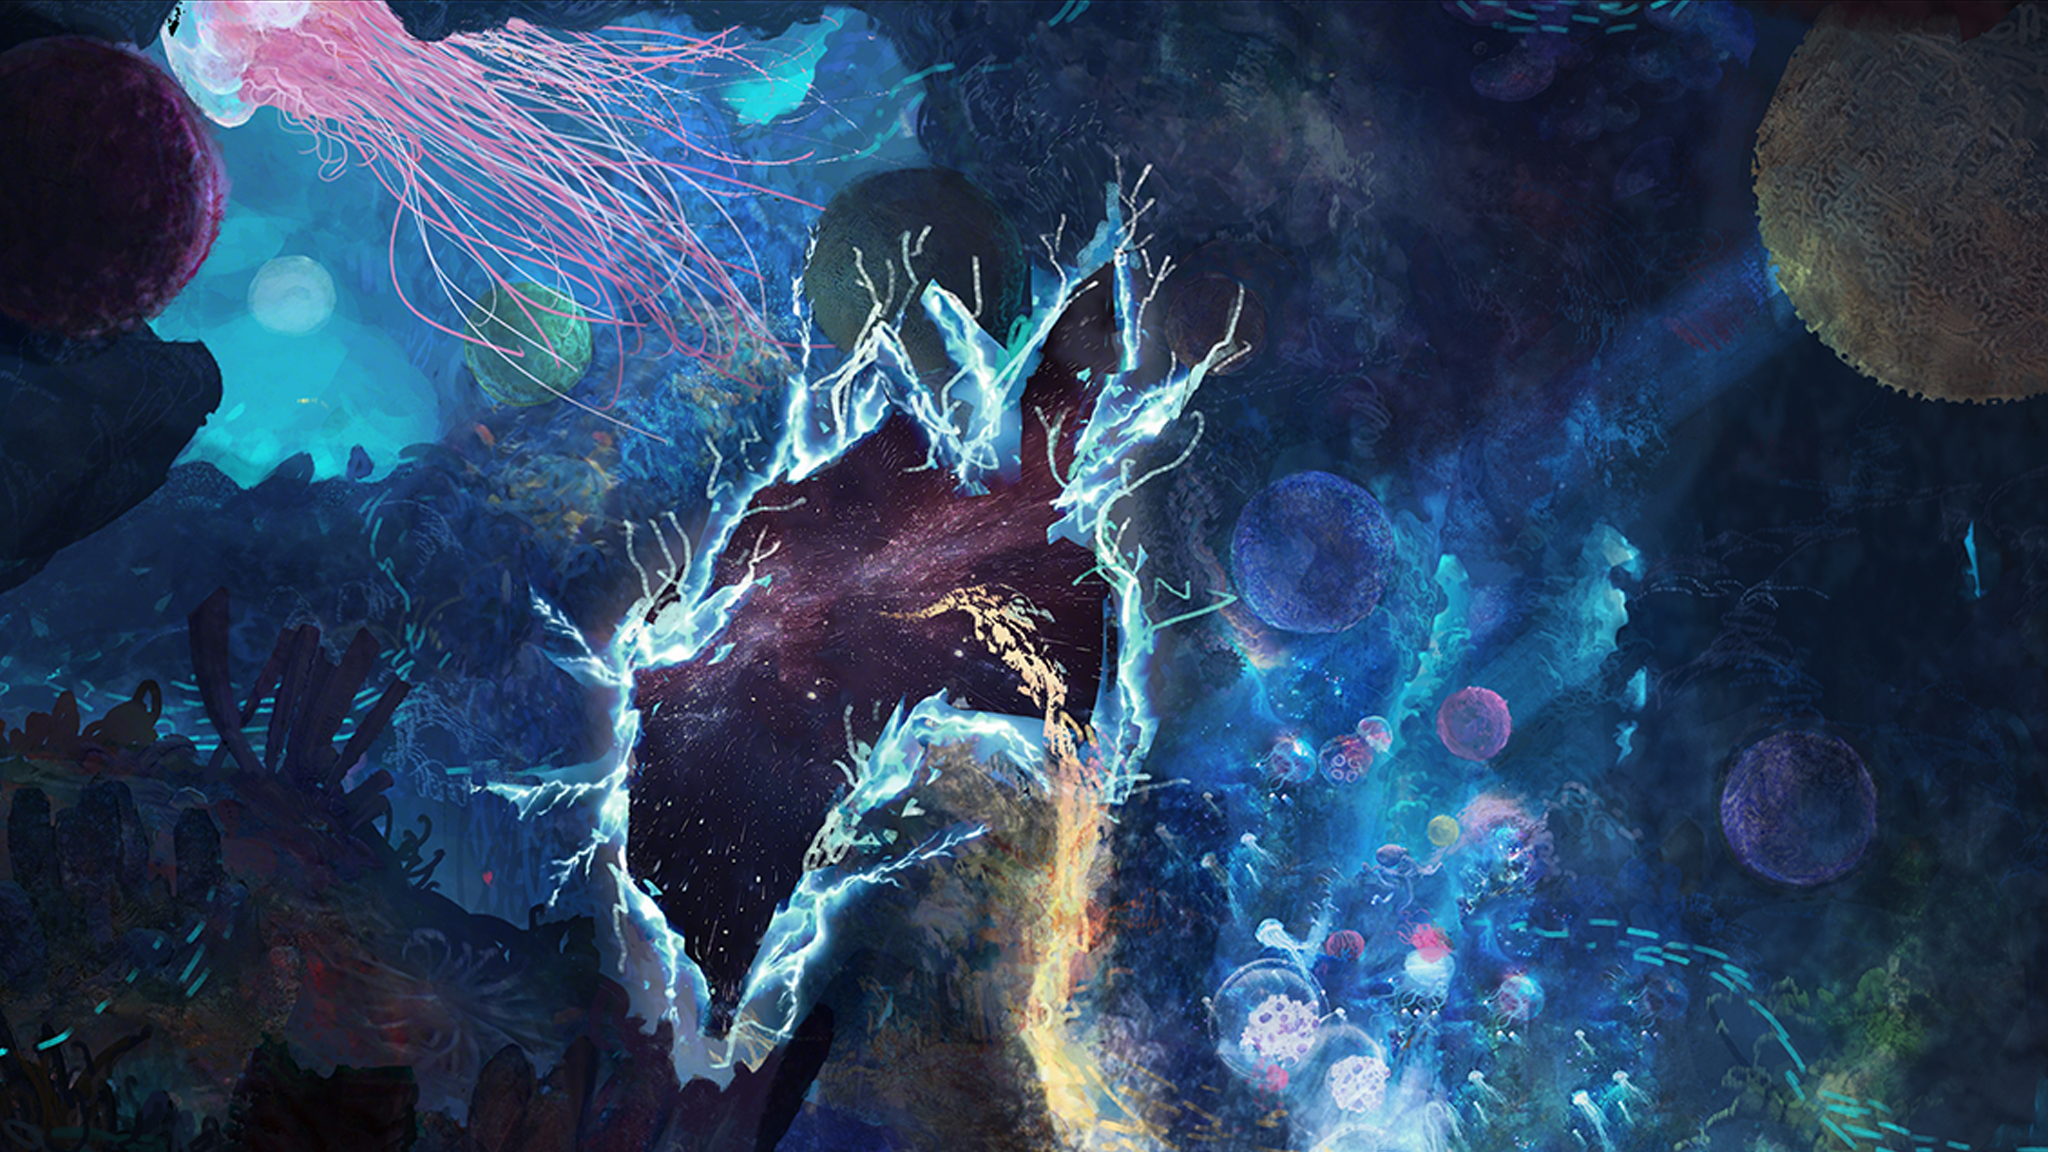7pic 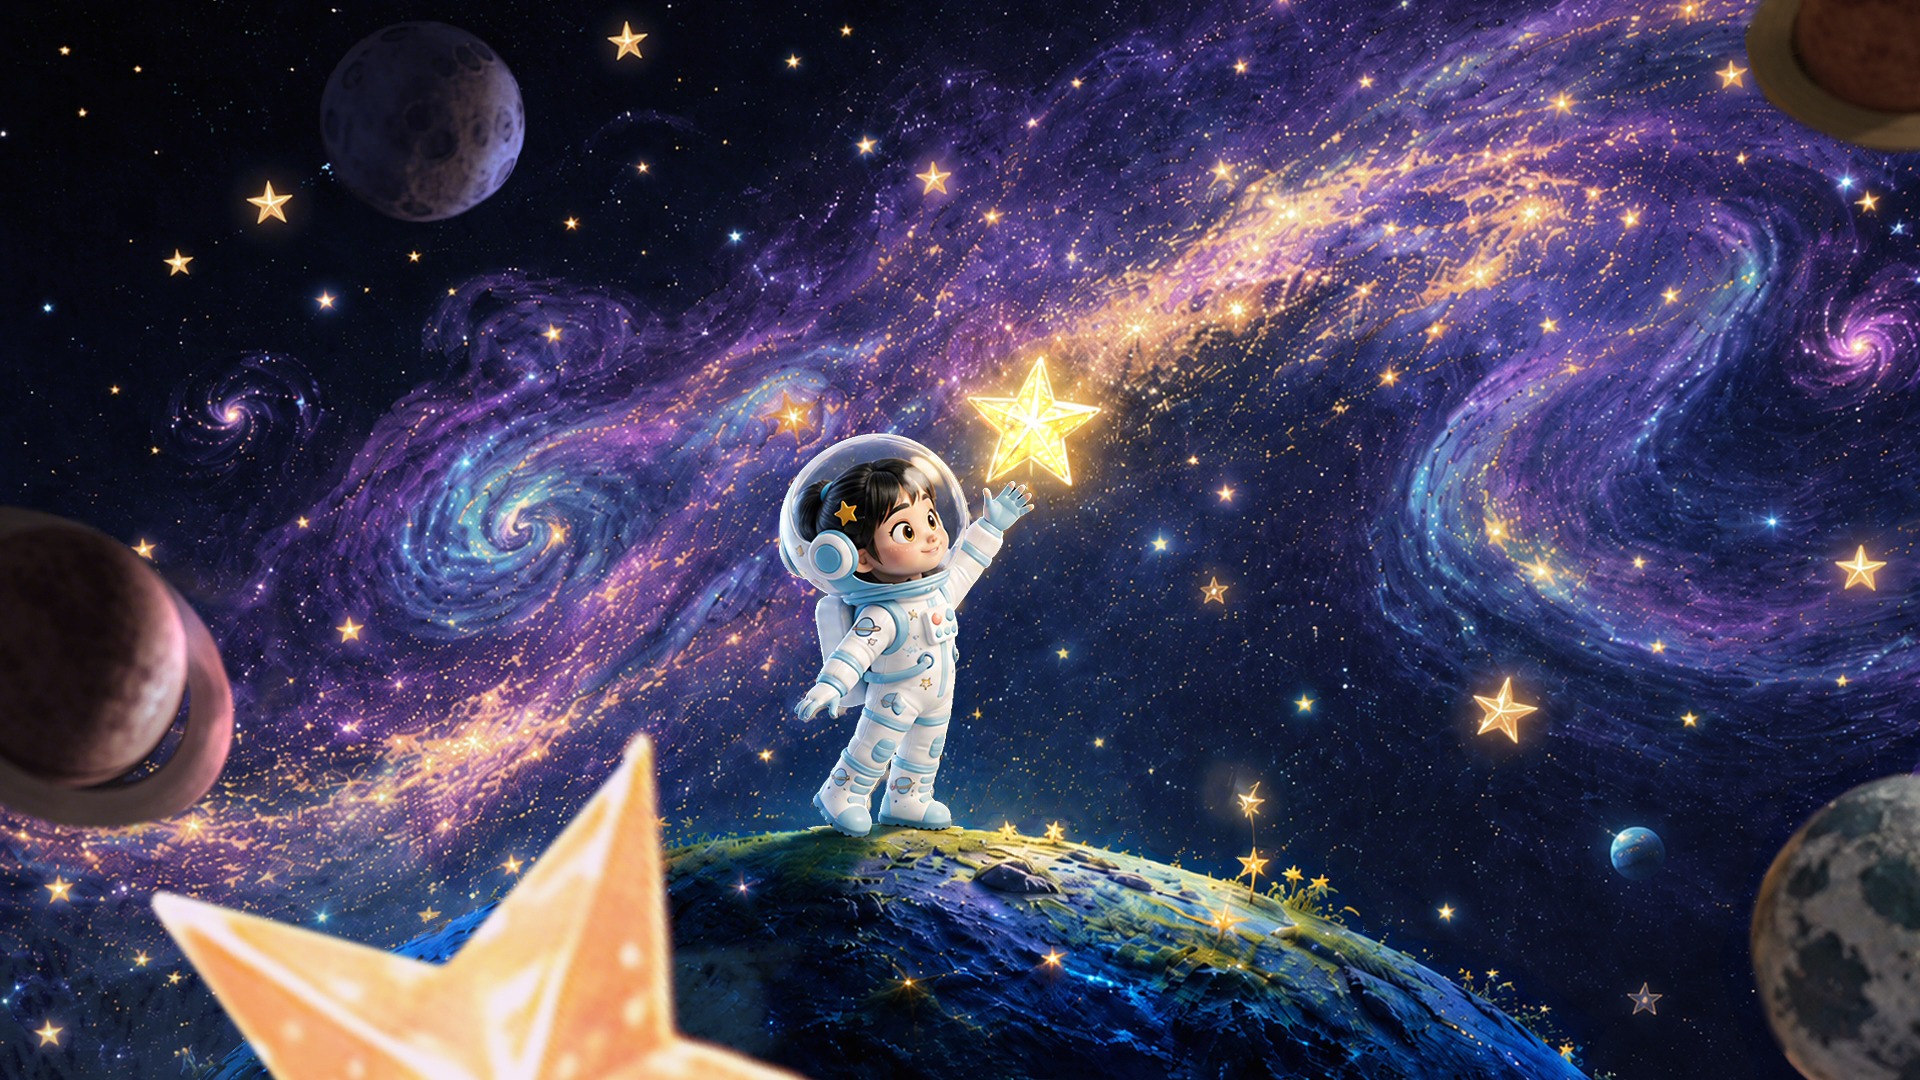8pic 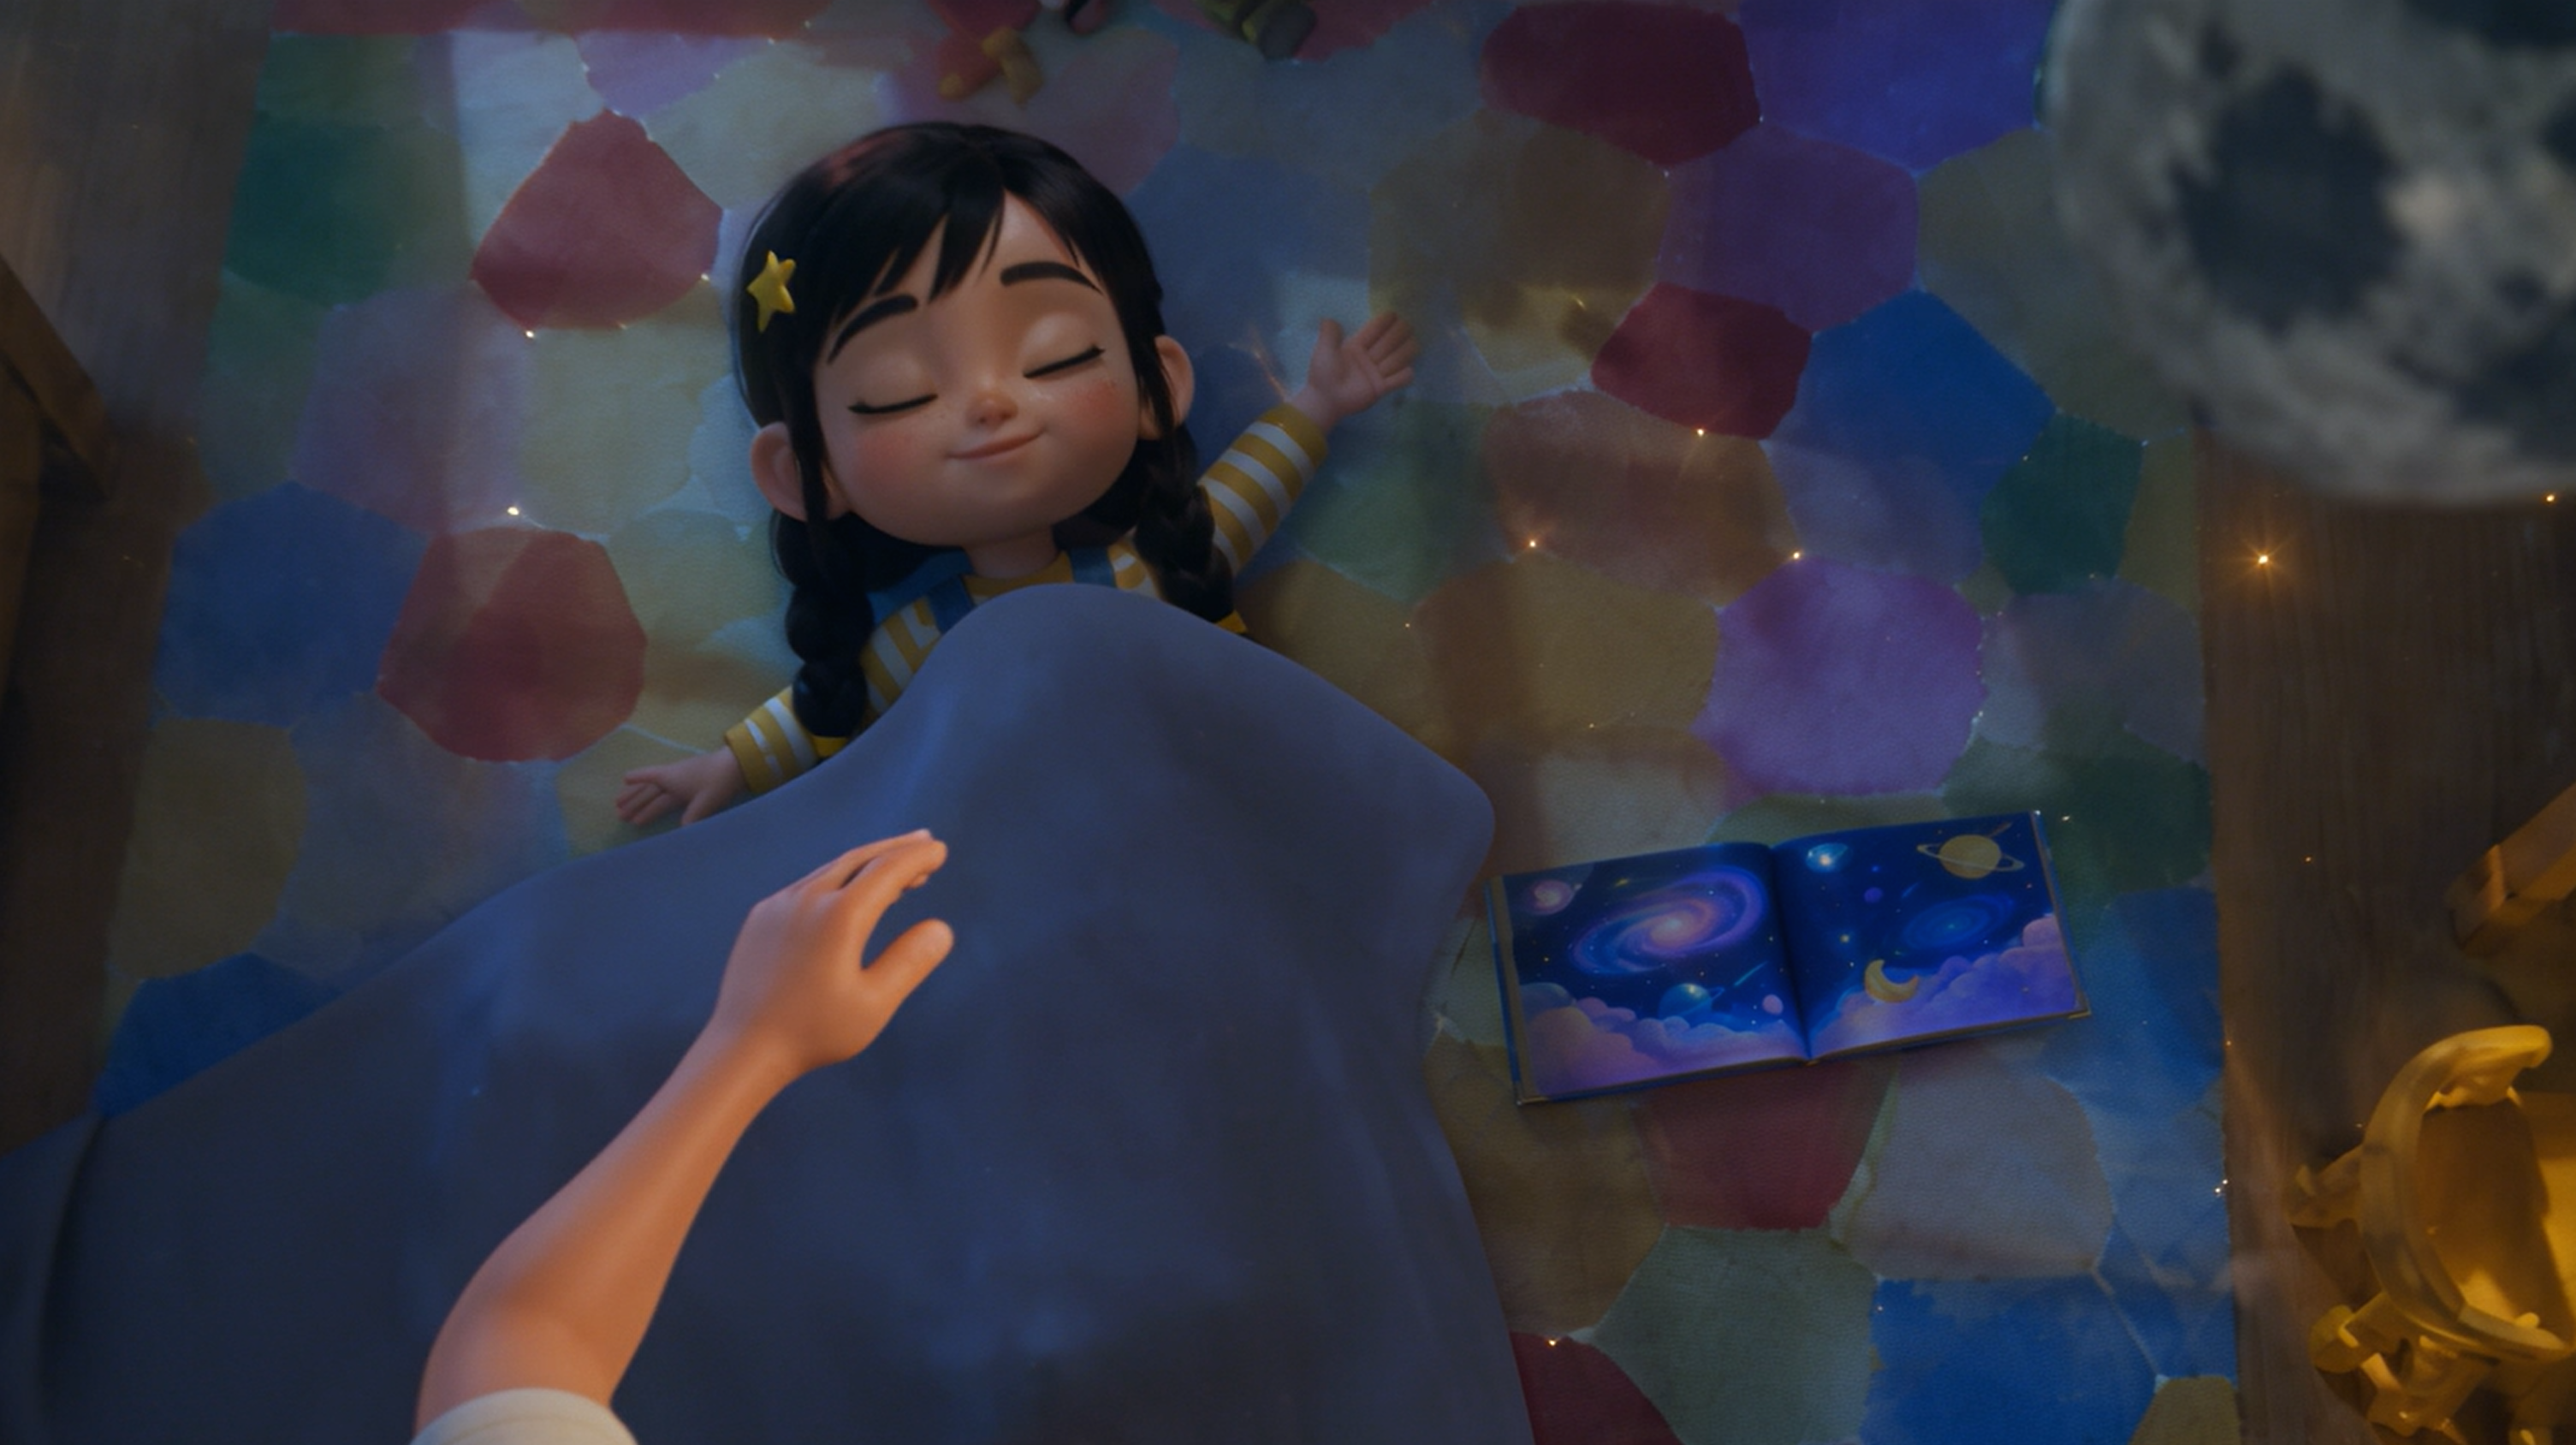9pic 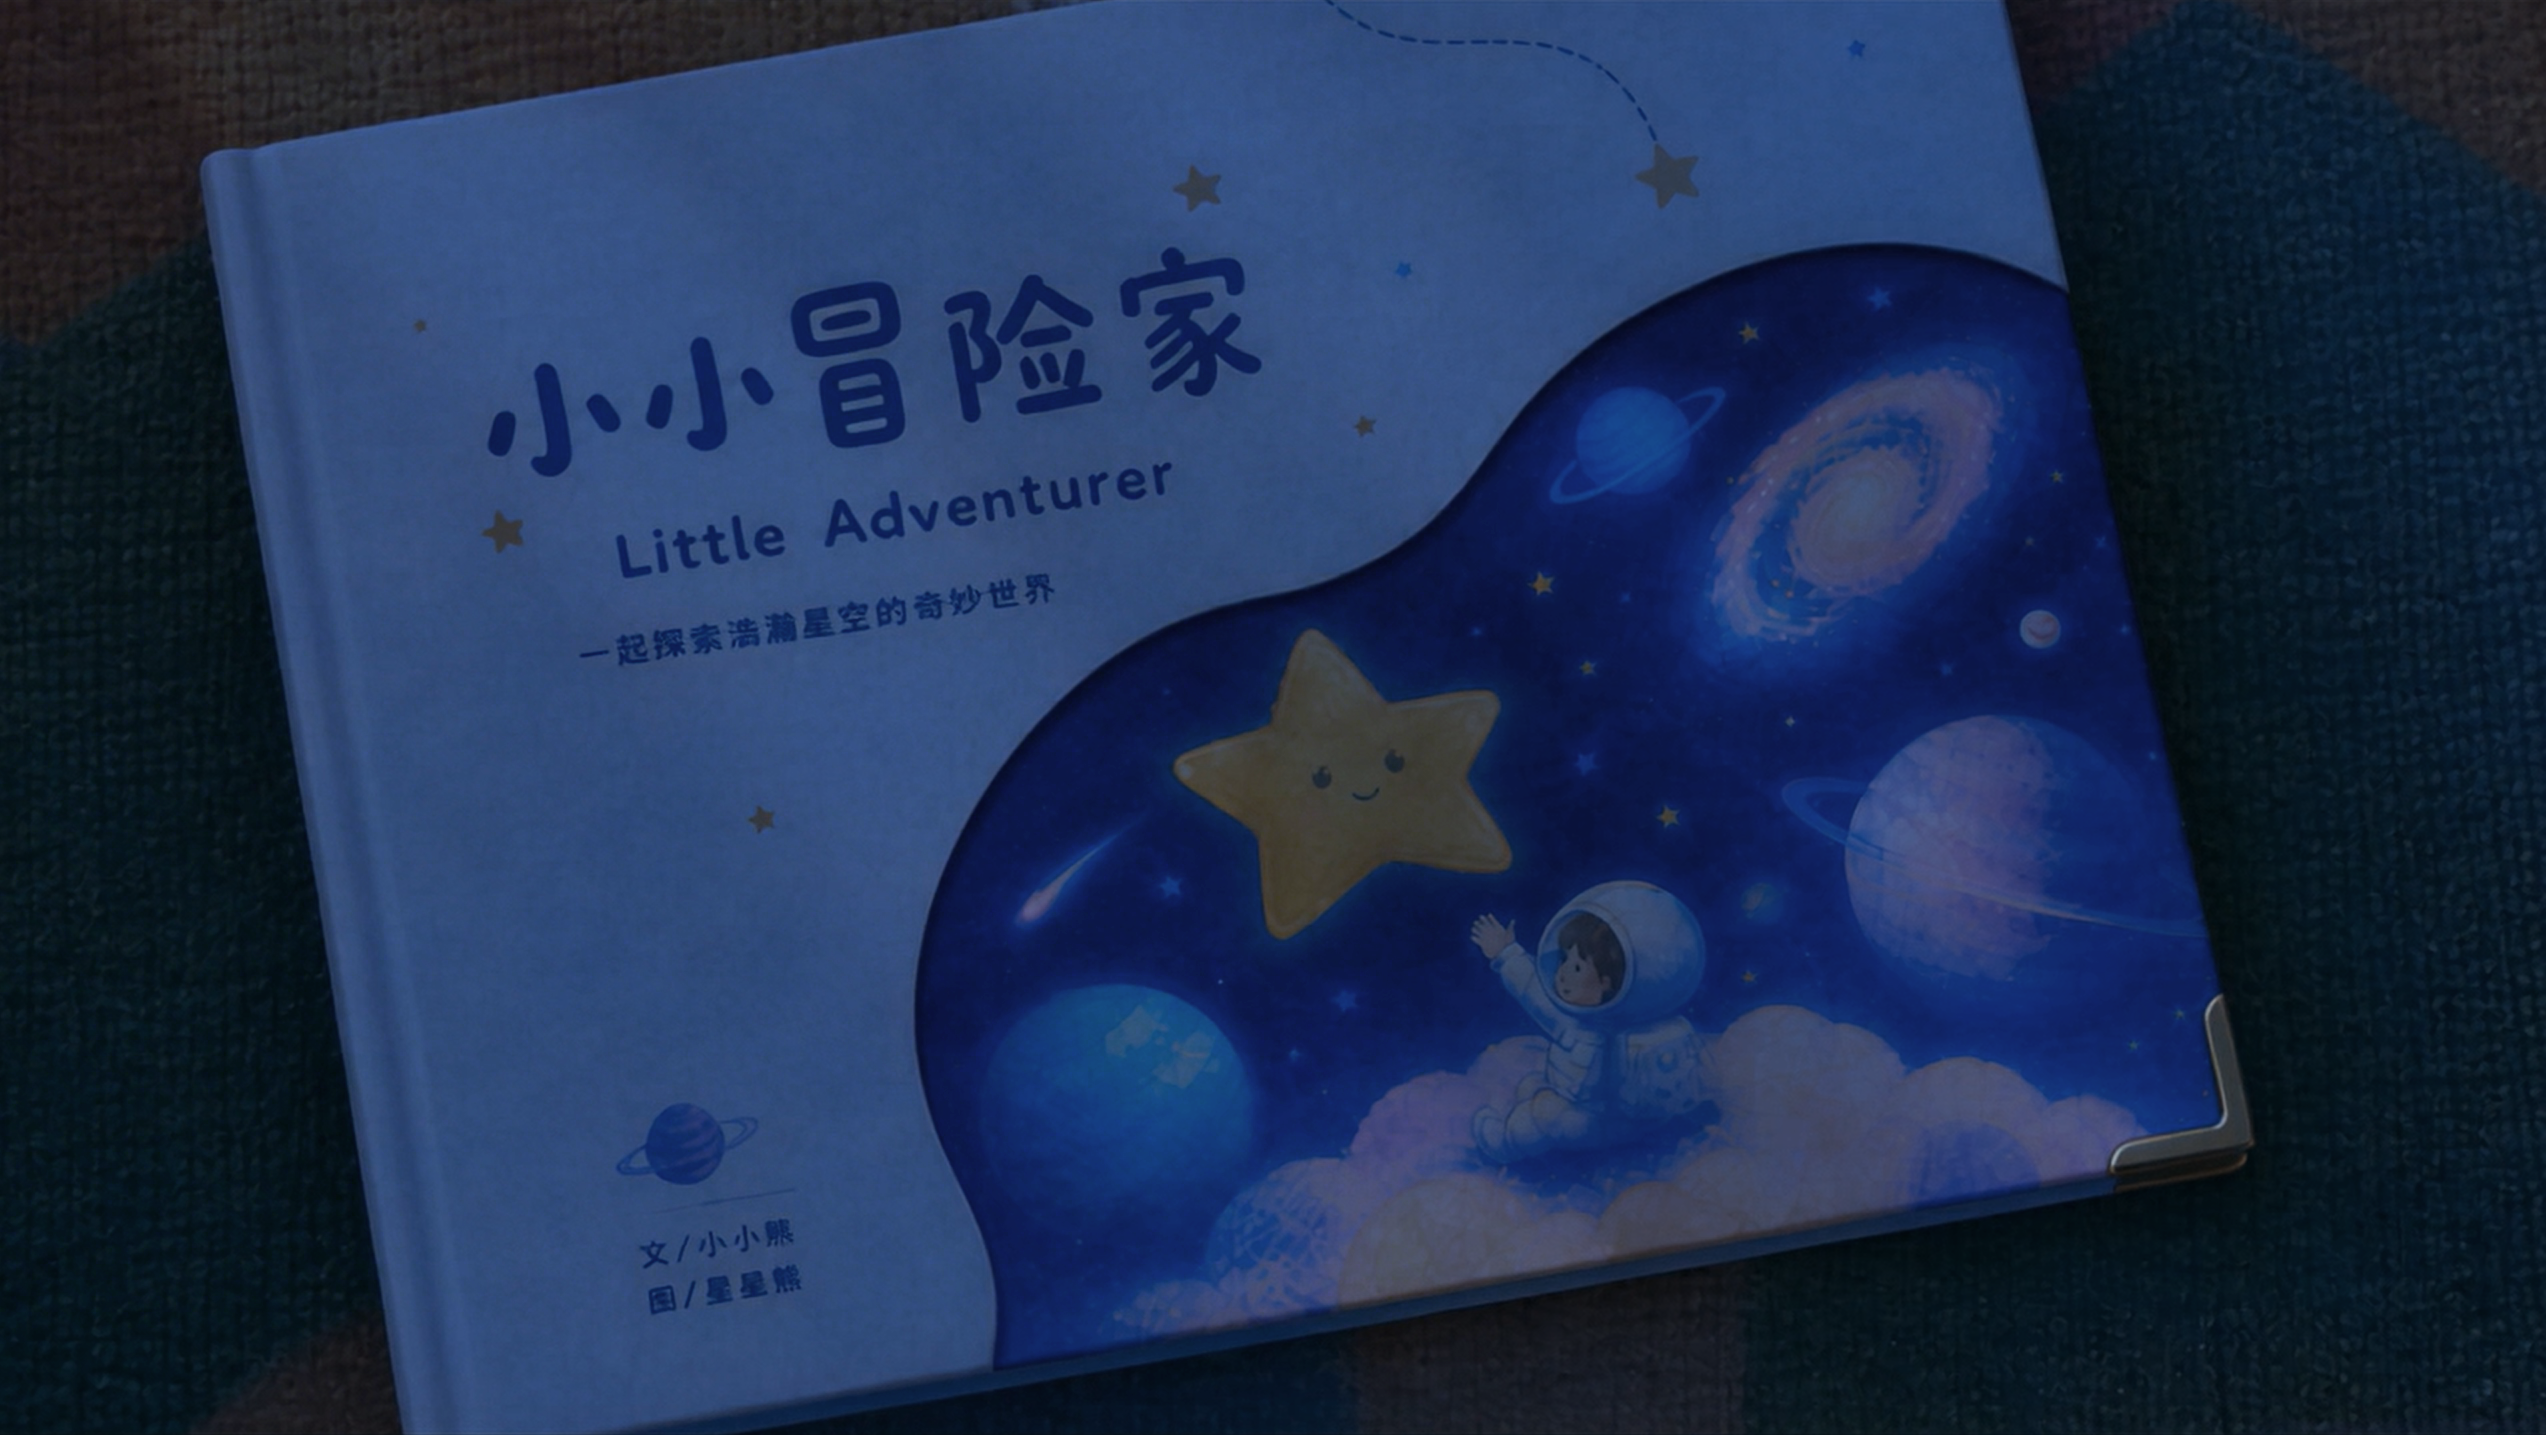10pic 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 同步对比视频: 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x - 服务于建模完整,重点解决重渲染的场景,给「白模上色」获得更好更丰富的渲染效果。 - 尽量提供完整且清晰的细粒度白模视频, 不含【轨迹线】【坐标线】【相机 cone】等干扰信息 的视频,否则容易泄露到生成后的视频中。 输入:文本 将视频 1 进行白模渲染,无 bgm,只生成环境音和动作音。 渲染要求:背景为深蓝与紫色色调的夜晚赛博朋克都市,密集的摩天大楼,楼宇间是巨大的全息广告牌与霓虹灯光,数个飞行器在空中穿梭,闪着微弱的灯光,发出微弱的机械声响;人物为一个身着黑色夜行衣的小浣熊,身影为一道剪影,脚步小心翼翼;人物移动的地点是摩天大楼中的一栋楼的屋顶。 输入:视频 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 高难度白模预演 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 复杂 3D 白模的结构与镜头调度逐帧承接,渲染出成片质感。 输入:文本 image1: 九宫格分镜参考,用于整体镜头结构、景别与运镜节奏。 image2: 火箭发射场黄昏草原实拍参考,用于环境构图、暖金夕照与冷暮蓝的写实彩色实拍质感基准。 image3: 主体 1 (守护机器人) 角色外观参考。 image4: 主体 2 (老奶奶) 角色外观参考。 【主体设定】 主体 1 (守护机器人): 参考 image3,近未来做旧复古机器人,做旧蓝绿色金属机身、斑驳锈蚀,圆顶头,两只发光的红色圆形机眼,细天线,细长关节四肢;体型高大,约为人类两倍高。 主体 2 (老奶奶): 参考 image4,瘦小年迈女性,银发挽成低髻,皱纹深刻,身穿明黄金色及地长裙、缀金蓝刺绣胸襟,神情不舍;身高只及机器人胸口。 环境 (黄昏草原・发射场): 参考 image2,近未来黄昏草原,暮色天空由暖金渐入冷蓝,远处地平线一座发射台矗立白色火箭、蒸汽升腾;及膝野草随风起伏,广袤空旷。 【整体风格】 真人实拍彩色电影正片,写实照片级质感,全程真实彩色画面;彩色 35mm 电影胶片质感,细腻真实胶片颗粒,浓郁饱满的电影级调色,IMAX 大画幅质感;手持摄影,呼吸感摇晃,浅景深大光圈,前景持续飘散的草叶、火星与灰烬,微微倾斜荷兰角,暖金夕照与冷暮蓝、爆炸暖橙强烈对撞,16:9 横屏。近未来温情灾难片氛围,静谧、悲壮、守护与不舍。 【严格排除】黑白、单色、灰度、去色;手绘、素描、线稿、插画、漫画、动画;分镜稿 / 故事板、草图;移轴微缩、玩偶感、塑料 CG、油腻过曝 CG。 【分镜头】(9 镜 ≈ 30s) 镜头 1 (0\-3s): 超远景低机位仰视,黄昏草原两人背影仰望远方火箭。台词 (机器人): "I'm right here. I won't let go." 镜头 2 (3\-6s): 正面中景手持,机器人搀扶老奶奶。 镜头 3 (6\-10s): 面部特写,老奶奶眼含不舍。台词 (老奶奶): "Fly safe, my child. Come back to me." 镜头 4 (10\-14s): 超远景仰摇,火箭升空拖曳浓白烟迹。台词 (老奶奶): "There he goes... there he goes." 镜头 5 (14\-18s): 超远景,火箭在半空爆炸碎裂。台词 (老奶奶): "No... no, no—" 镜头 6 (18\-22s): 面部大特写,老奶奶瞳孔骤缩泪滑落。台词 (老奶奶): "...he was almost there." 镜头 7 (22\-25s): 特写转近景,老奶奶崩溃痛哭。台词 (老奶奶): "Bring him back! Please— bring him back!" 镜头 8 (25\-28s): 超低视角近乎垂直仰拍,机器人环抱老奶奶罩成保护穹顶。台词 (机器人): "Don't look up. I've got you." 镜头 9 (28\-30s): 超远景背影,两人紧紧相拥剪影。台词 (机器人): "I'm still here. I'll stay... as long as you need." 输入:图 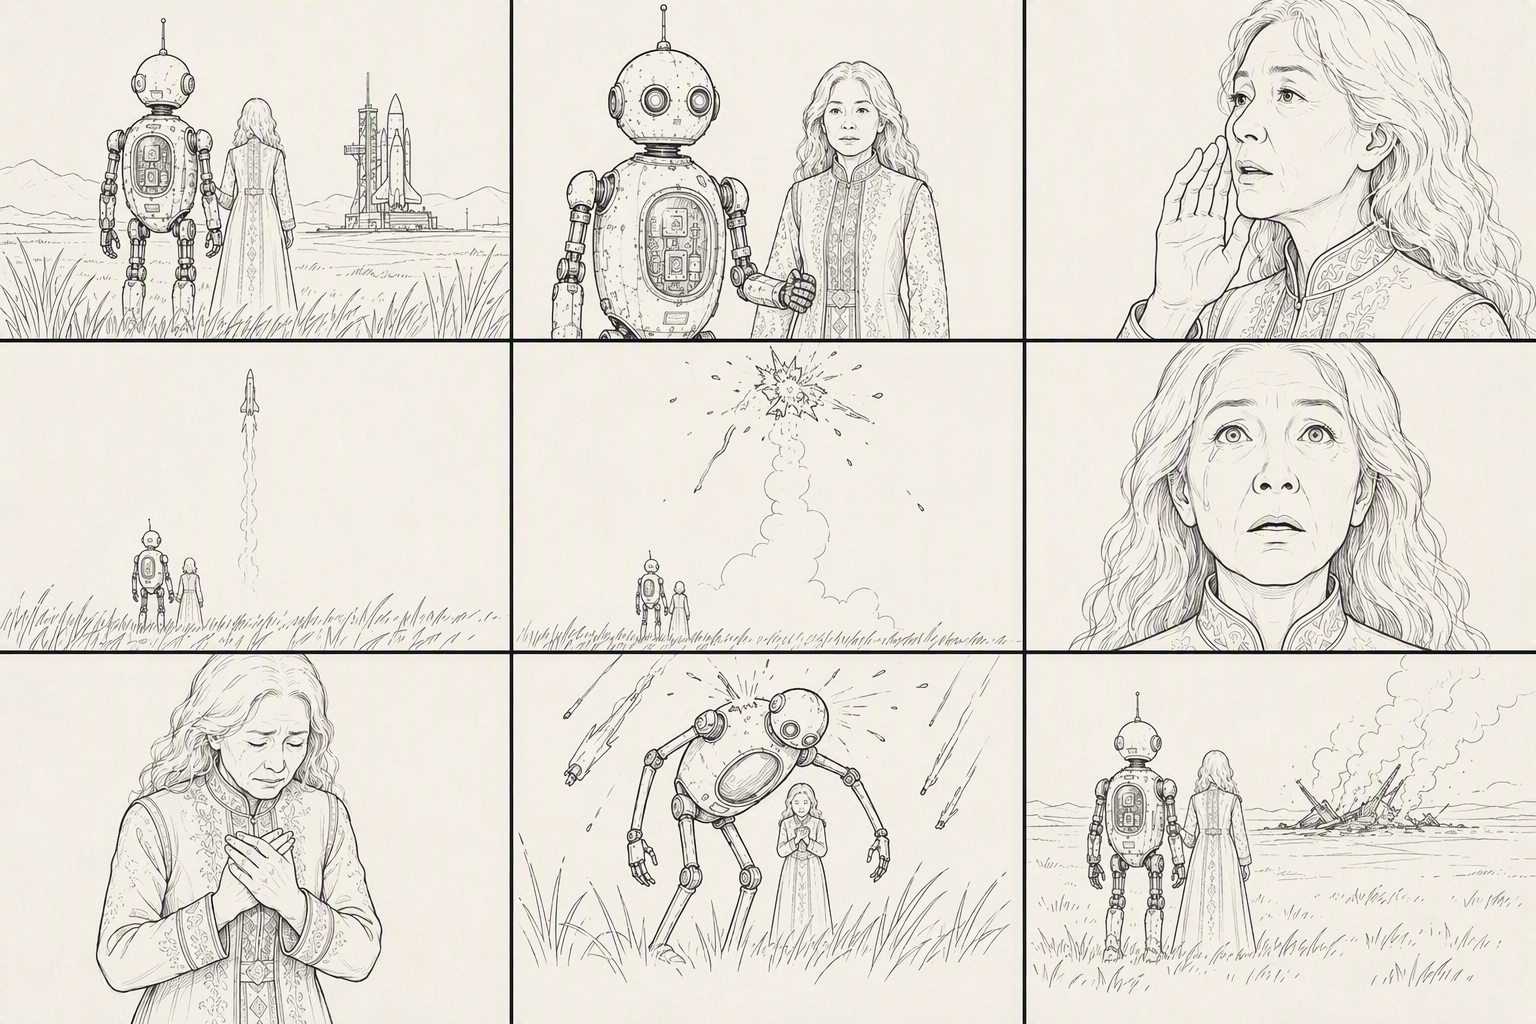image1 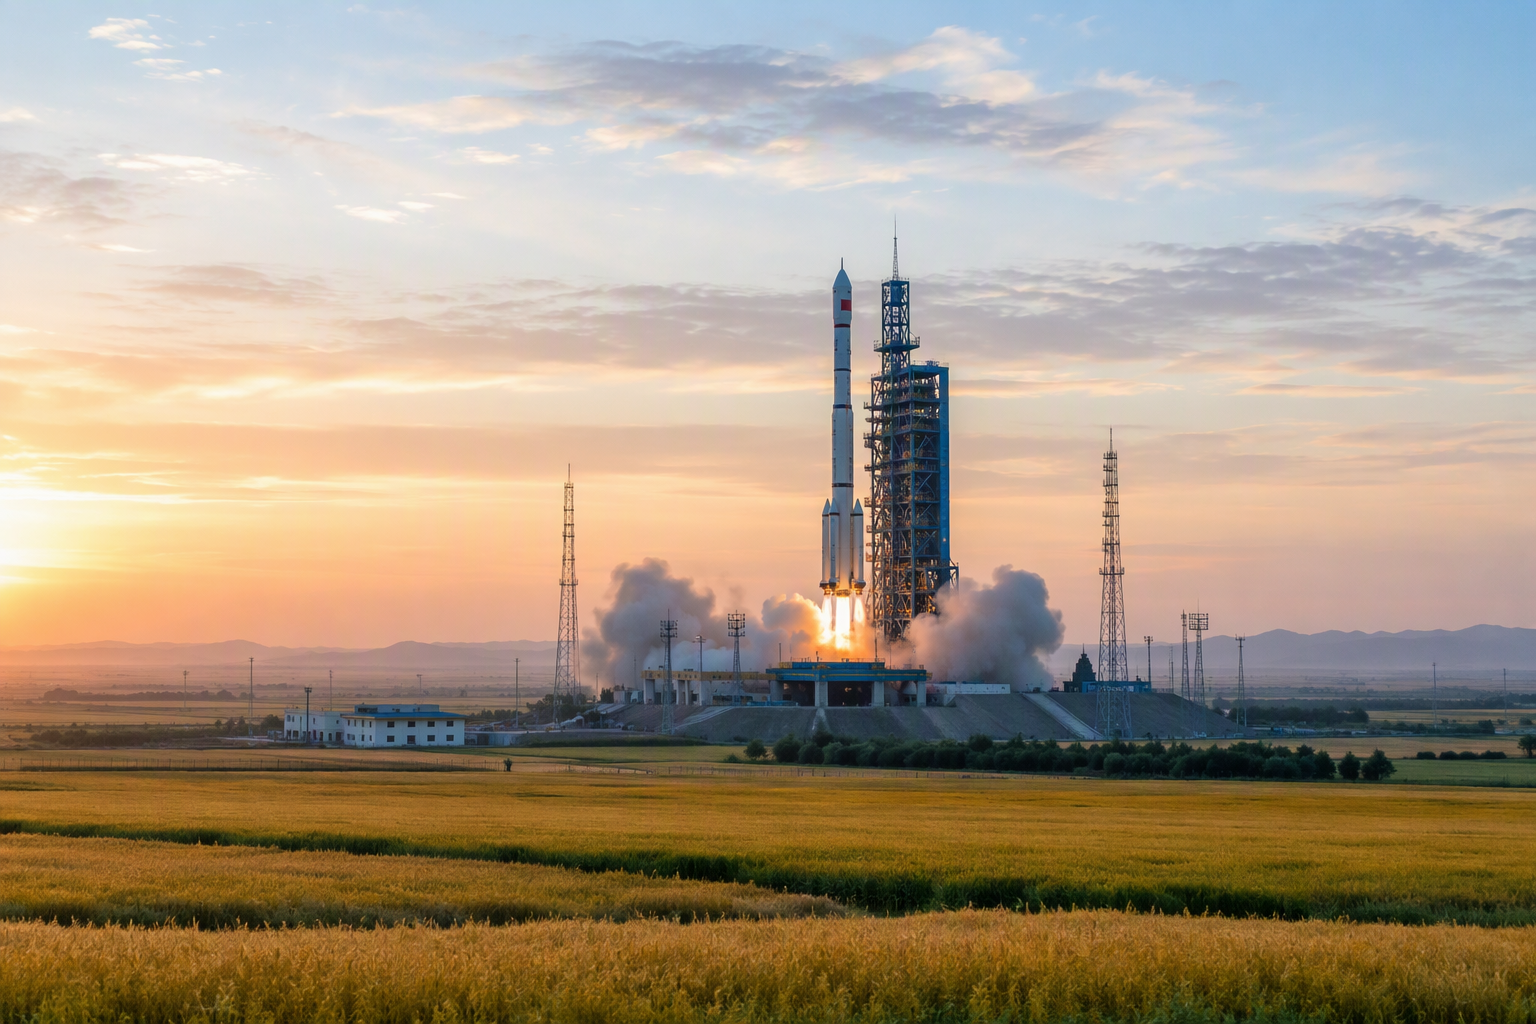image2 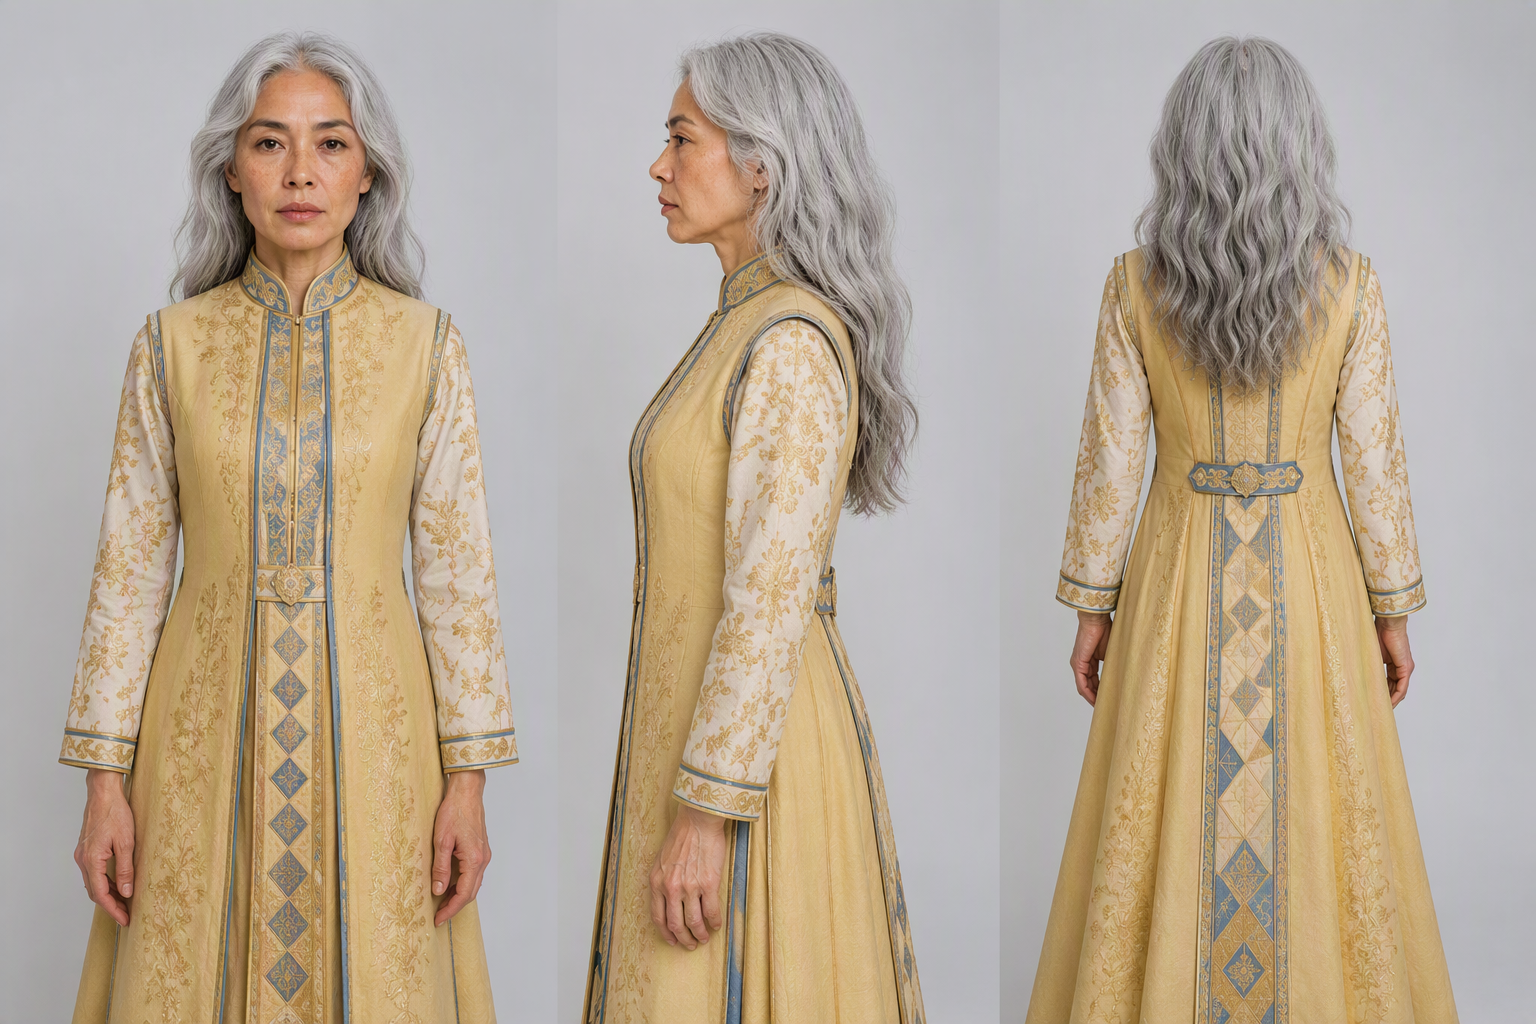image3 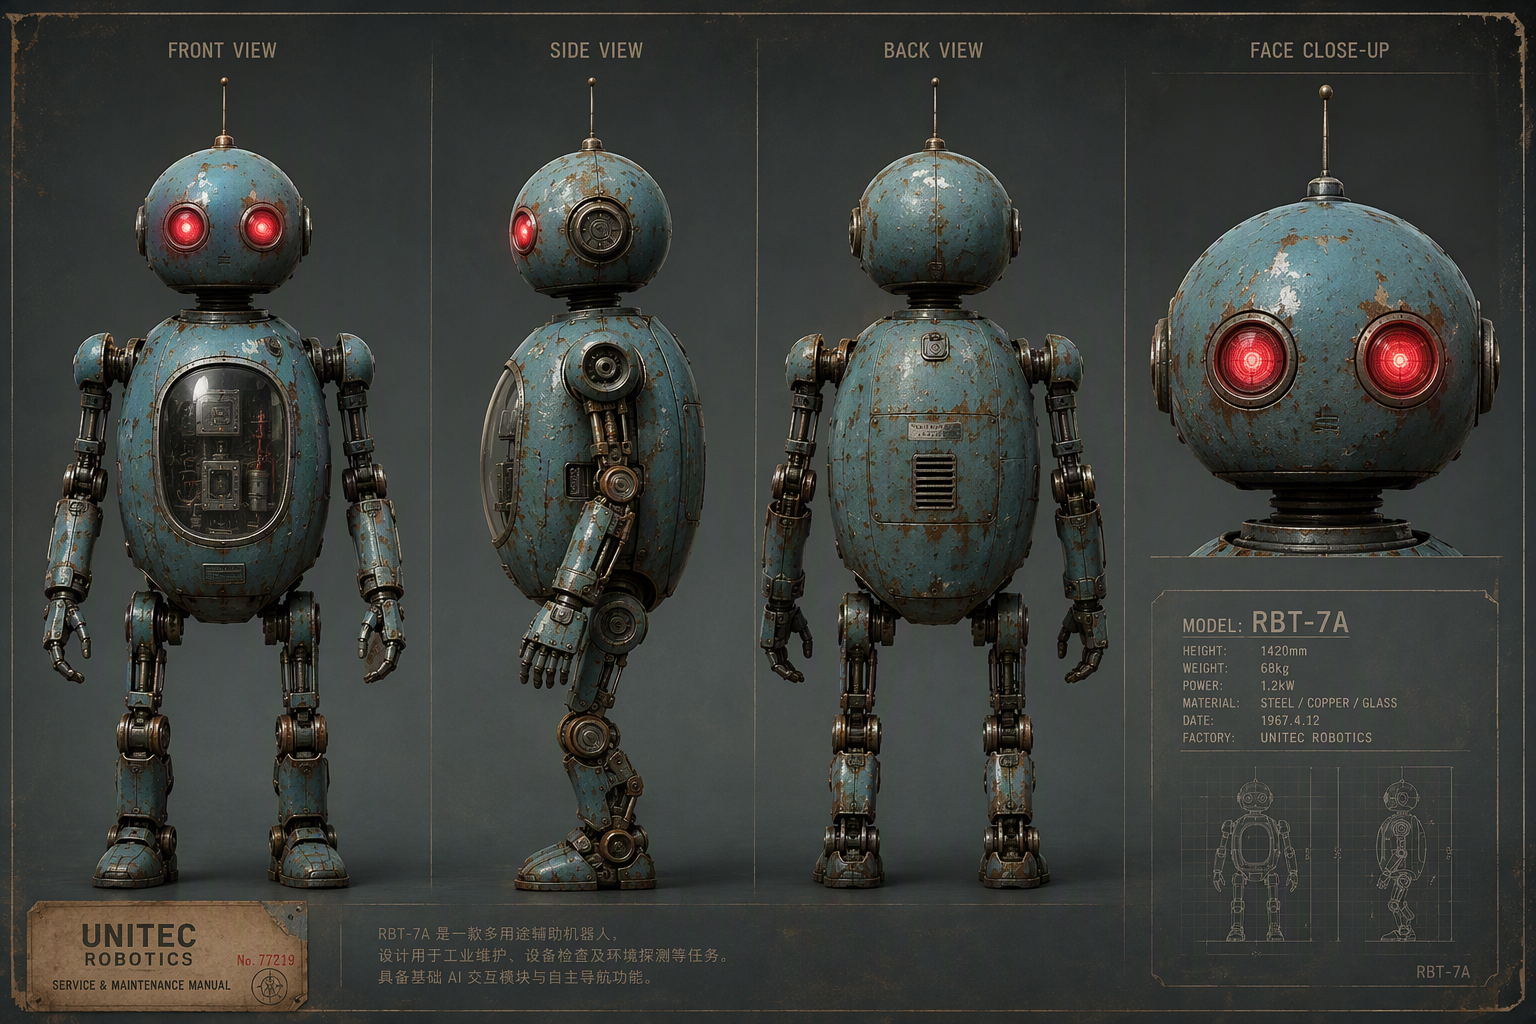image4 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输入:文本 根据 @图片1 \- @图片6 制作一镜到底的像素武侠主题竖版视频,背景音乐使用国风 8bit 武侠风格音乐。全片统一浅蓝底色,像素风格统一,画面干净通透。 镜头 1:静止展示 @图片 1 的「江湖风云」水墨风格 logo,背景为统一浅蓝底色,画面保持约 1 秒静止。 镜头 2:@图片 1 中的文字区域消失后,@图片 2 的武侠男性角色像素脸部特写从画面底部滑入;角色眨眨眼看向镜头,随后快速向下位移离场;角色离场后,原本 logo 处变为 @图片 3 的蓝色「武功秘籍」像素书。 镜头 3:紧接 @图片 4,像素武侠小人角色从画面下方用力向上跃出,顶起上方的蓝色菱形问号标,问号标上方弹出深蓝色粗体字「今日闯江湖!」;角色落地后摆出 @图片 4 的站姿 pose,随后抬手打招呼,接着做出预备跑动作,转身向画面右侧奔跑(奔跑姿态参考 @图片 5),镜头跟随角色向右移动,角色从画面右侧跳出画面。 镜头 4:@图片 6 的 UI 界面从画面右侧位移入画,像素武侠角色从画面右上角跳入,落在「三月廿七日」大字的右下方,张开双臂摆出热情展示的定格姿势,最终定格在该画面。 整体像素武侠美术风格,色调统一浅蓝底,运镜连贯顺滑呈现一镜到底的连续位移与跟随,元素过渡自然、角色动作衔接流畅,画面无卡顿、无闪烁;文字与 UI 清晰稳定。 输入:图 图片 1 图片 2 图片 3 输入:图(续) 图片 4 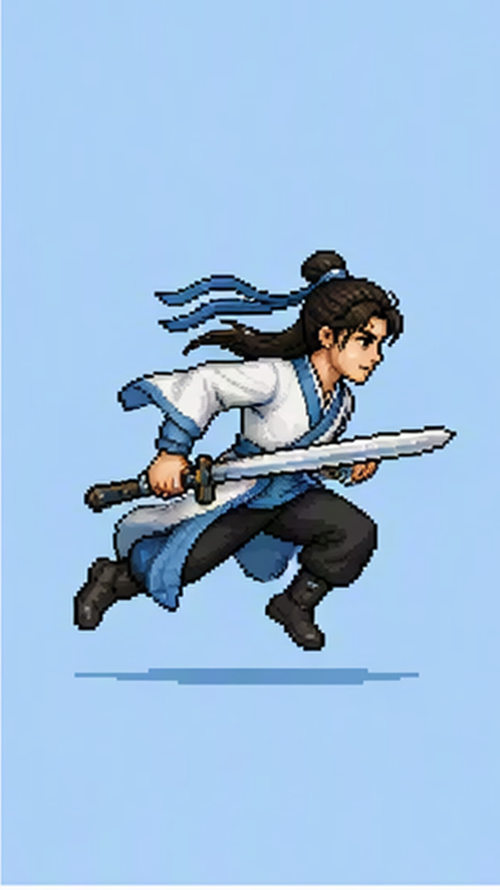图片 5 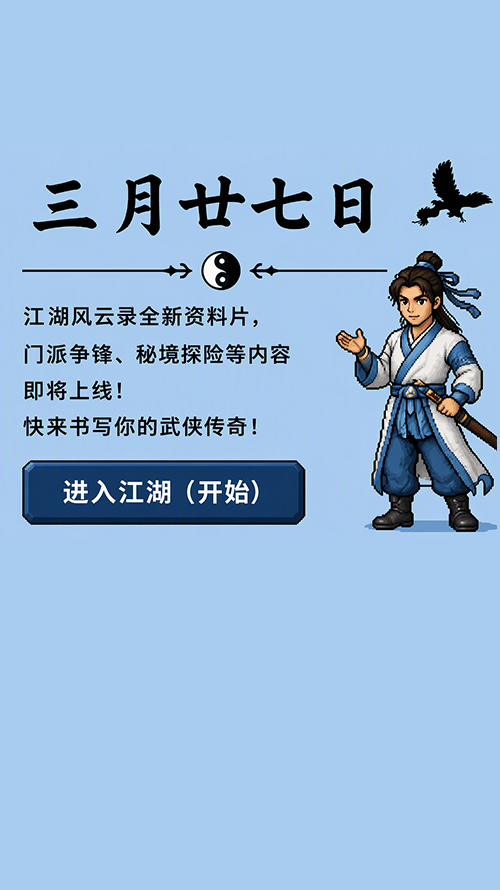图片 6 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 通过 Prompt 对视频画面内容进行增删改等编辑操作。 输入:文本 保留 @视频 1 的构图、机位、光线与表演节奏,只改写画面里女主的样貌与神情:让她从二十多岁自然地老去到六十岁,眼神里的隐忍慢慢化开,泪光滑过眼角,嘴角一点点扬起,最后破涕为笑。全程一镜到底,不跳切、不闪烁,五官随年龄渐变而不漂移。 输入:视频 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 通过 Prompt 对视频画面内容进行增删改等编辑操作,支持额外输入参考图引导编辑结果。 输入:文本 将两人武打素版视频 @视频 1 替换为冷兵器对决前的空手试探风。 场景替换为中世纪石堡平台、古老庭院平地、山间堡垒外平台或简洁石砖决斗场,背景为古堡墙体、风、雾、远处山线,地面平整石质 @图片 1。 视频中深色衣服的男子的服饰替换为 @图片 2,视频中浅色衣服的男子替换为 @图片 3。动作仍然保持不变,不改变原始节奏。 AI 特效仅做环境和质感强化:风吹衣摆、轻雾、接触点少量尘土、金属冷色反光质感、轻微颗粒和史诗感调色。整体风格为克制、真实、古典硬派决斗氛围。背景音乐卡点。 输入:视频、图 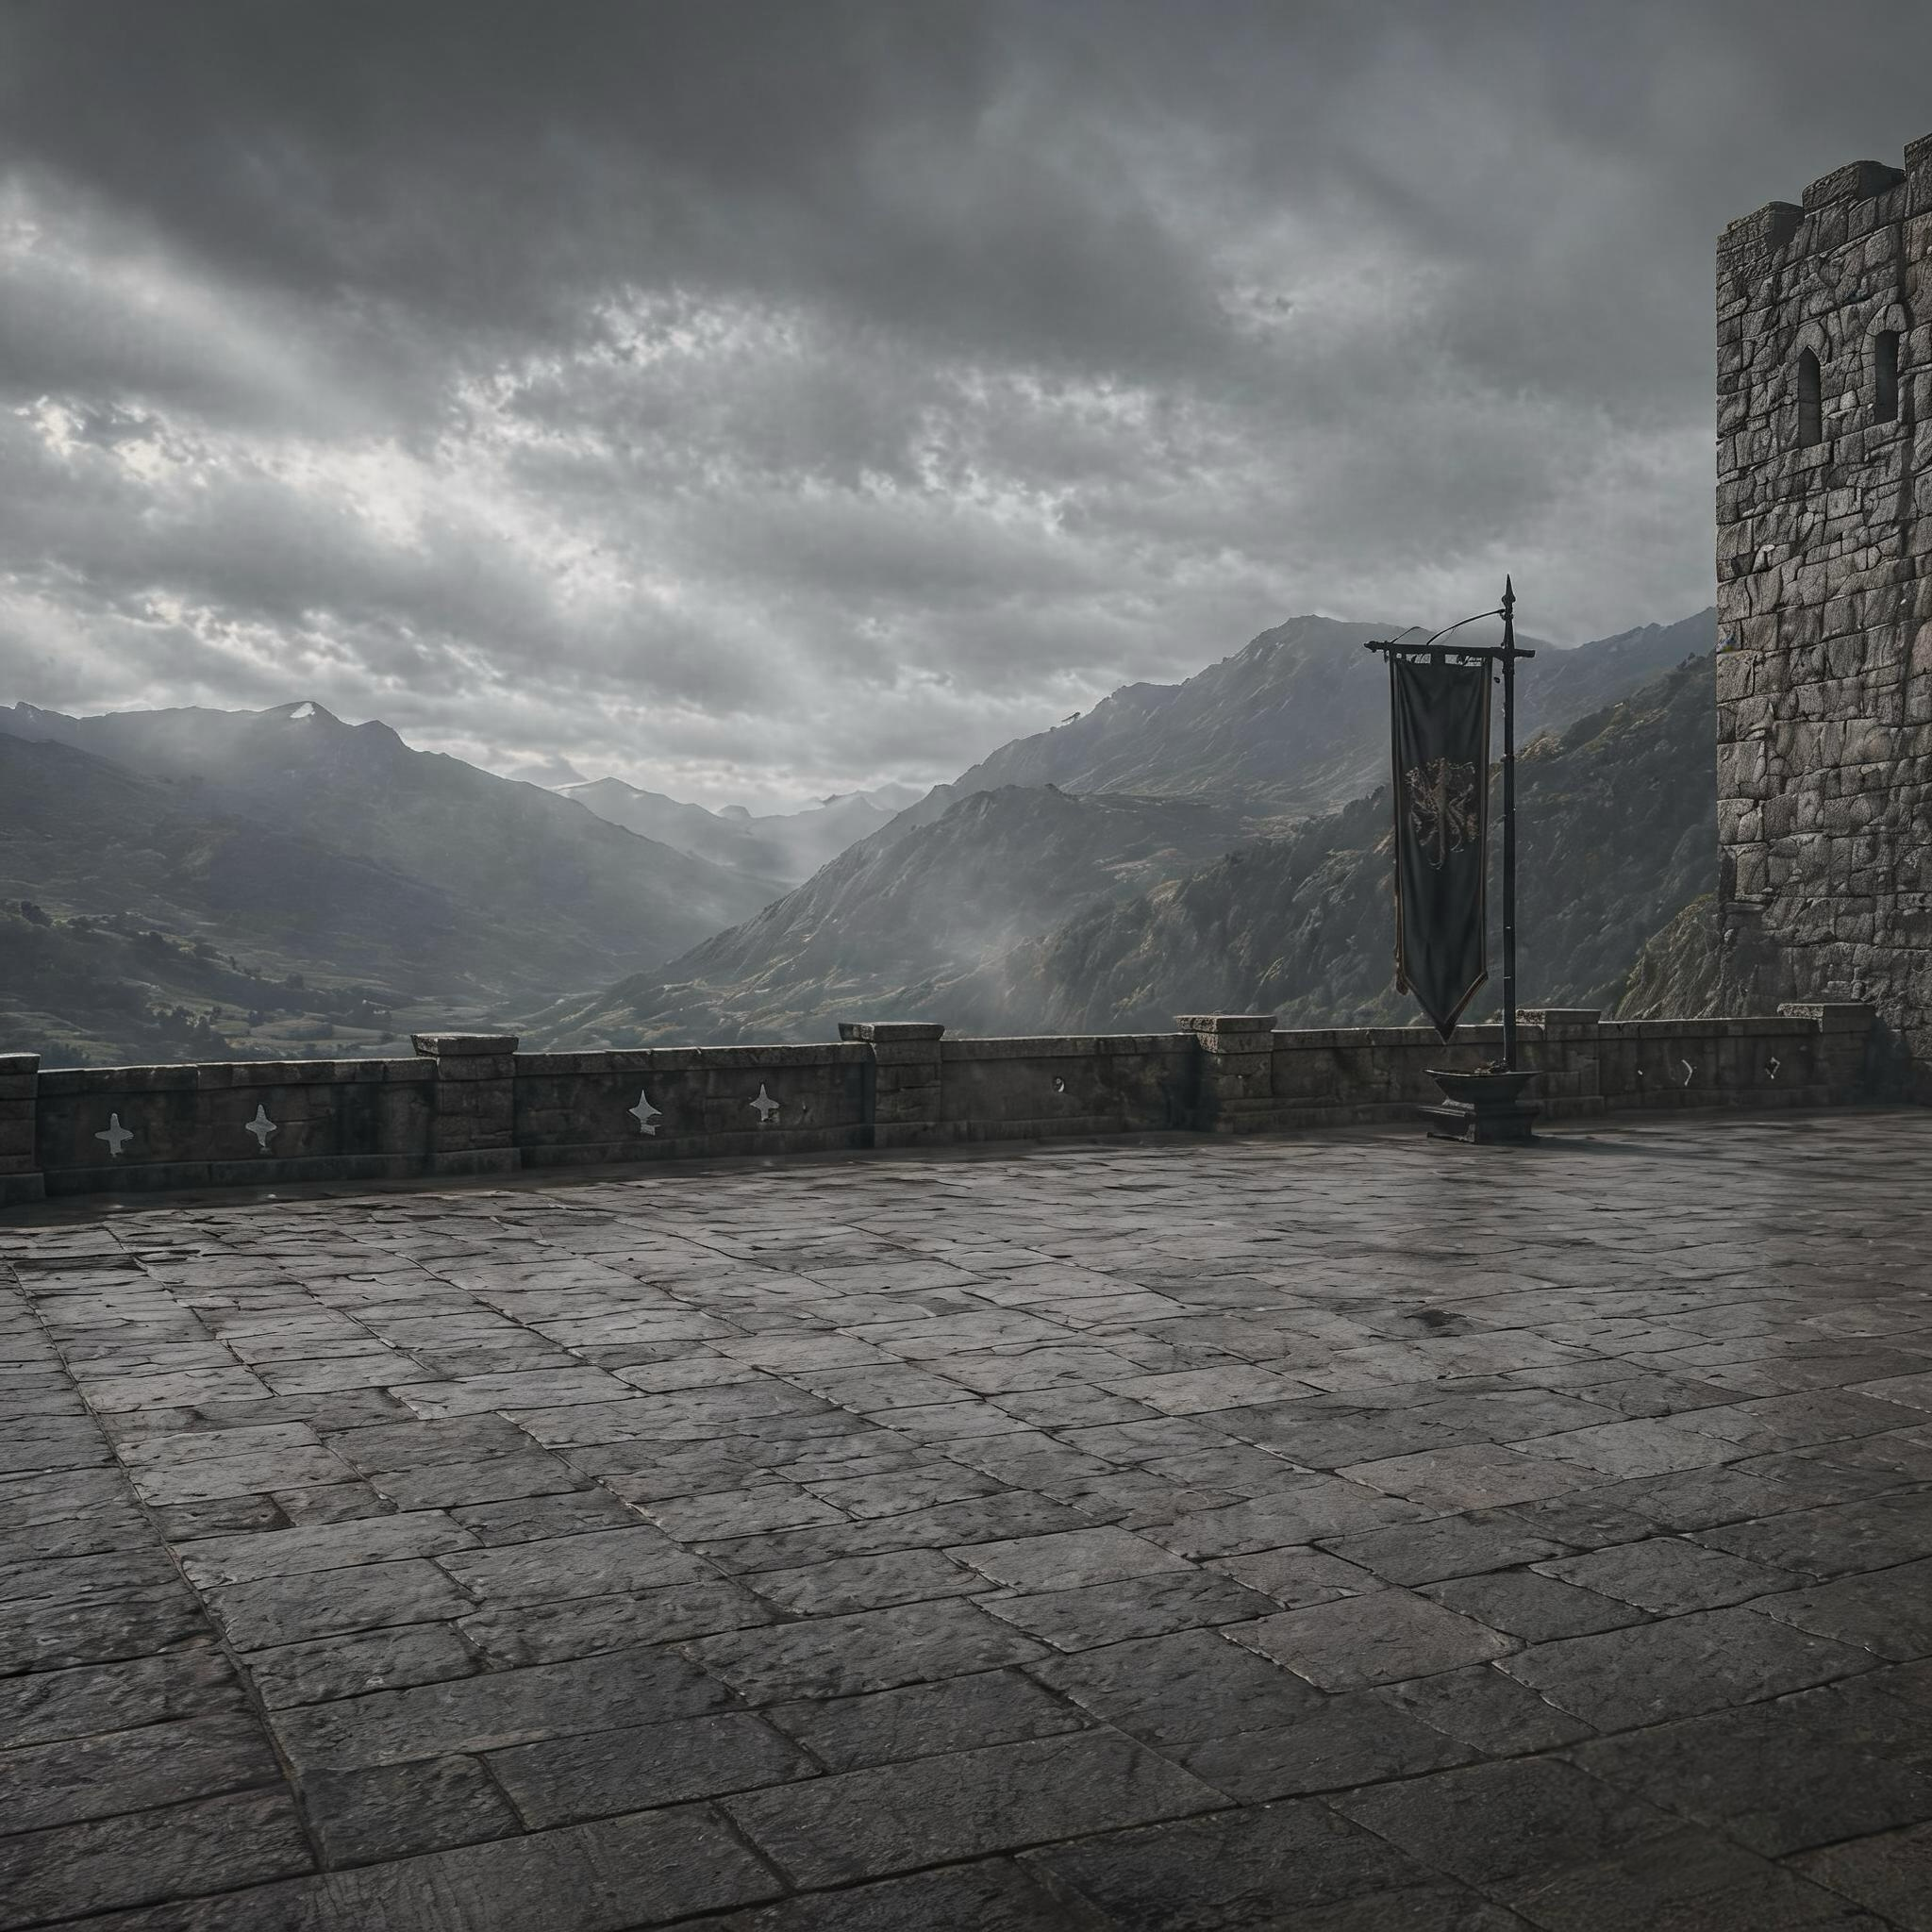图片 1 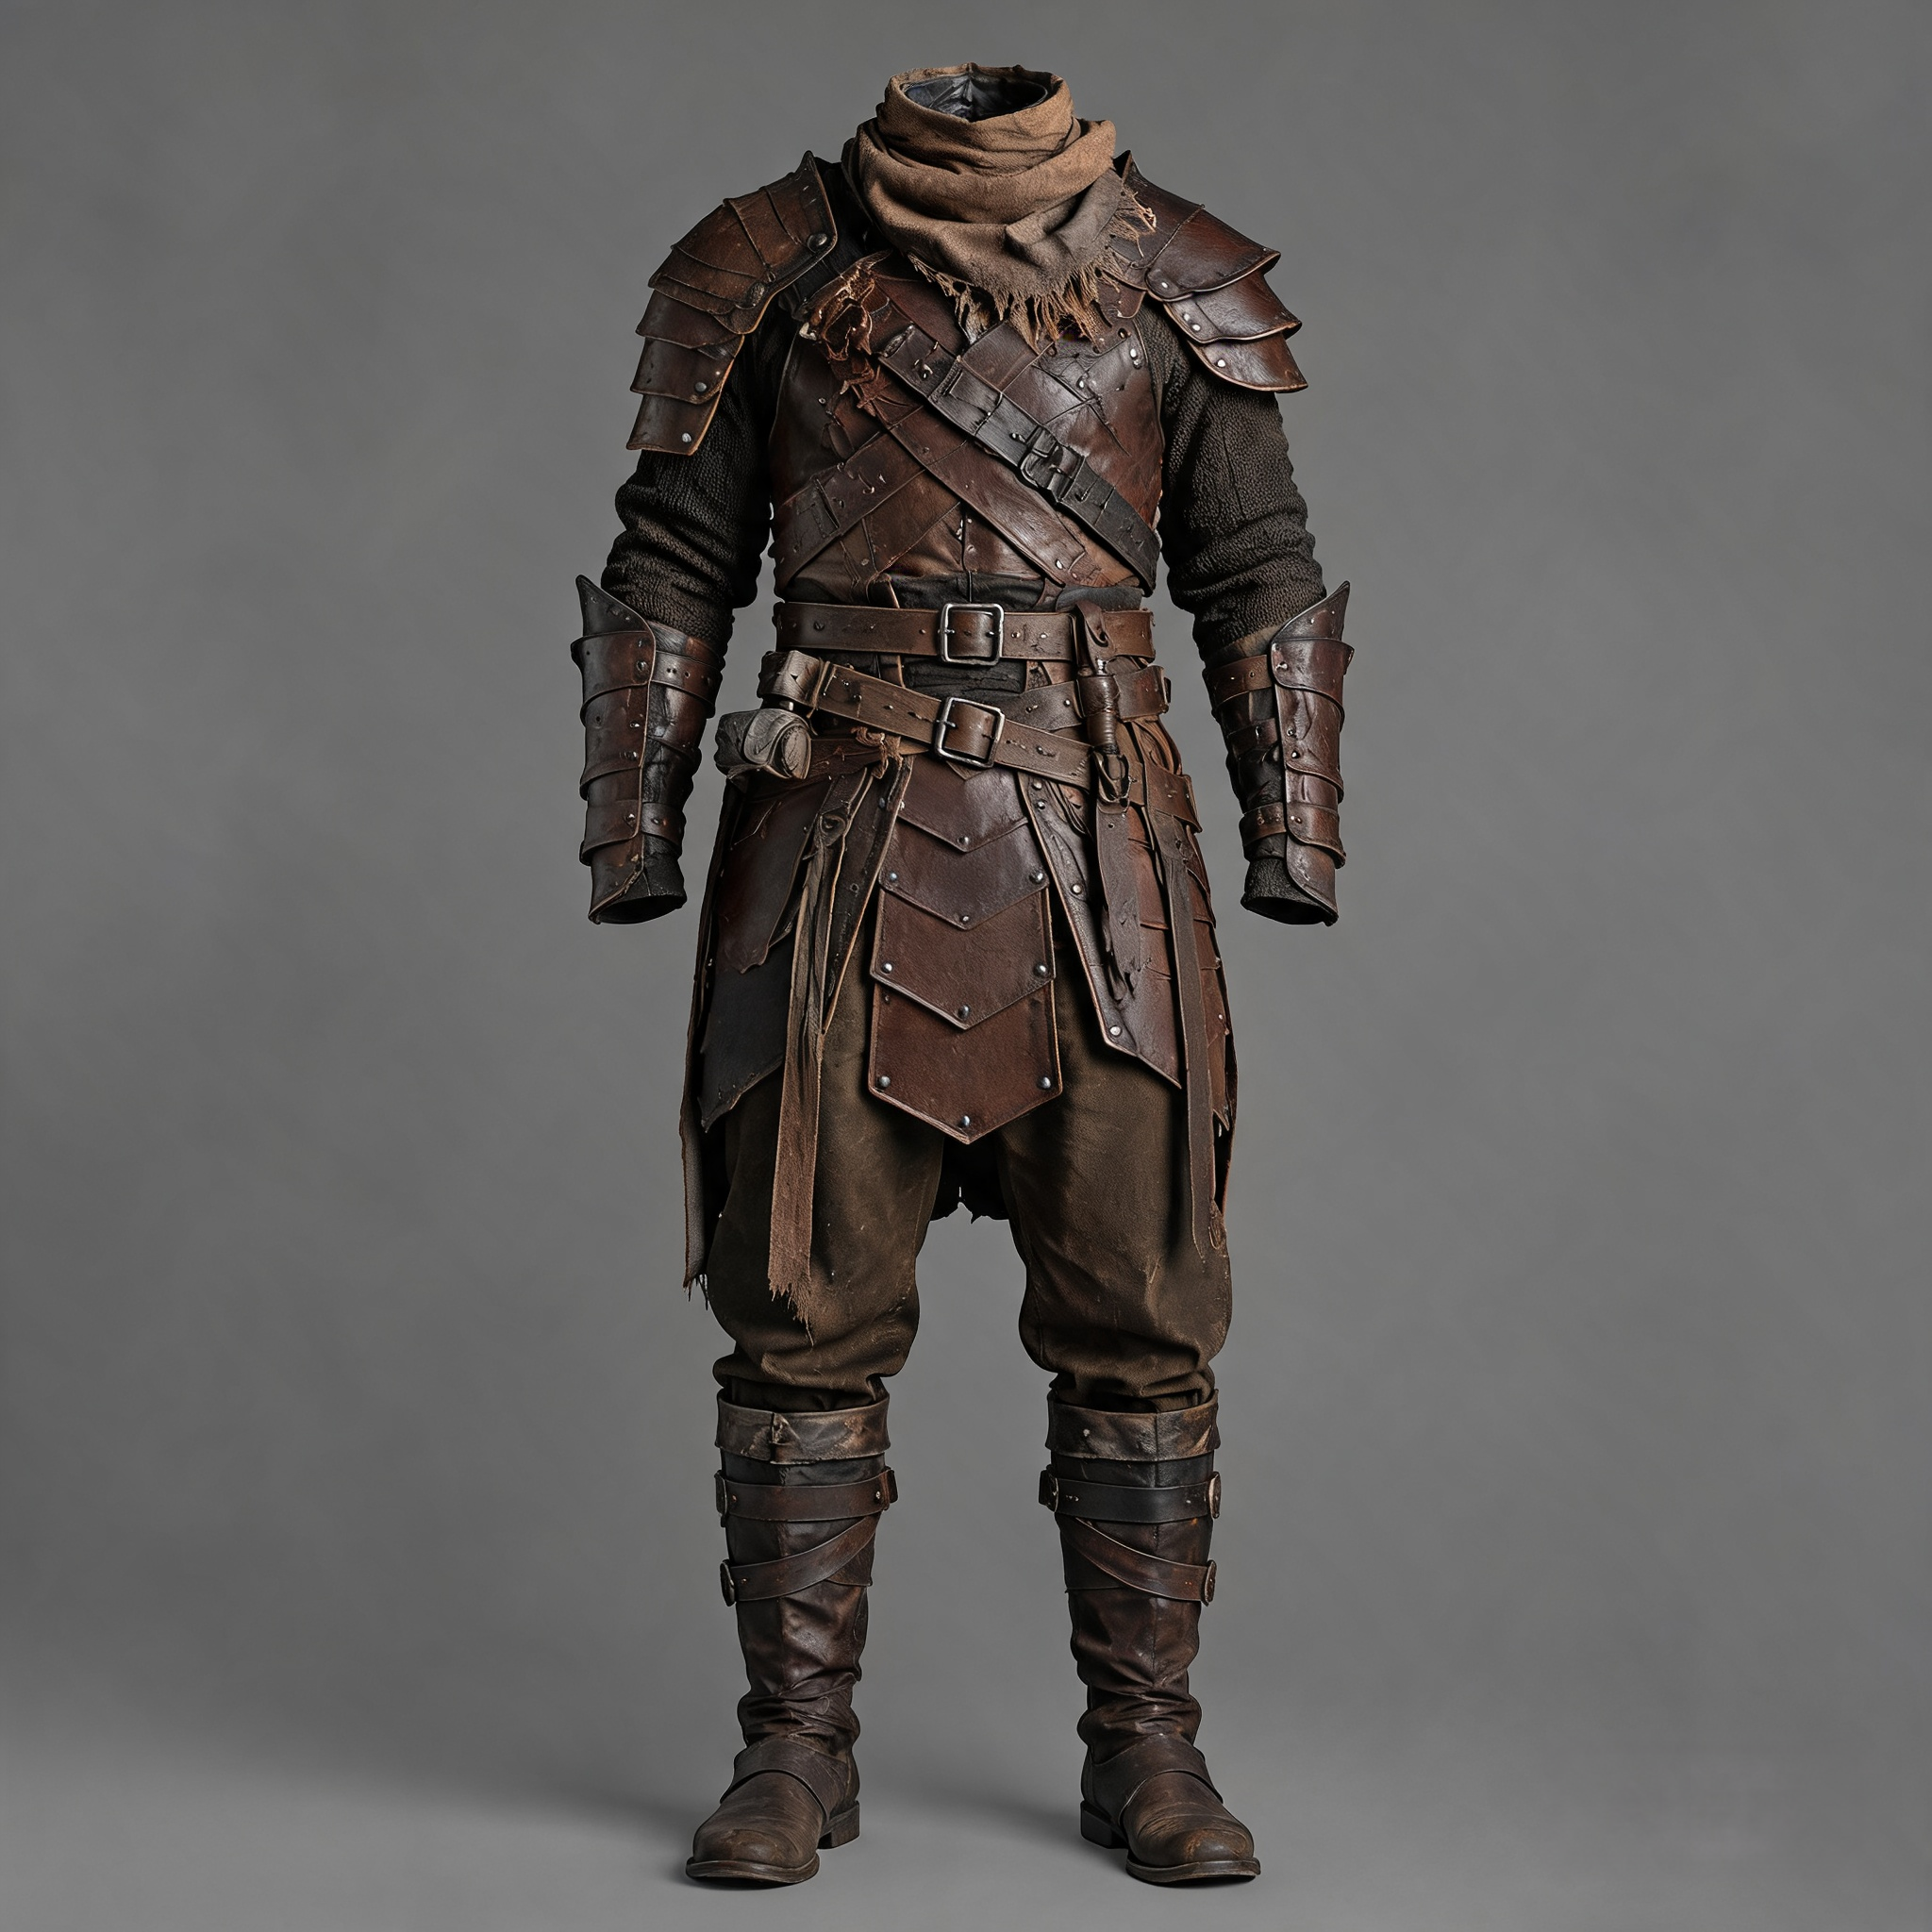图片 2 输入:视频、图(续) 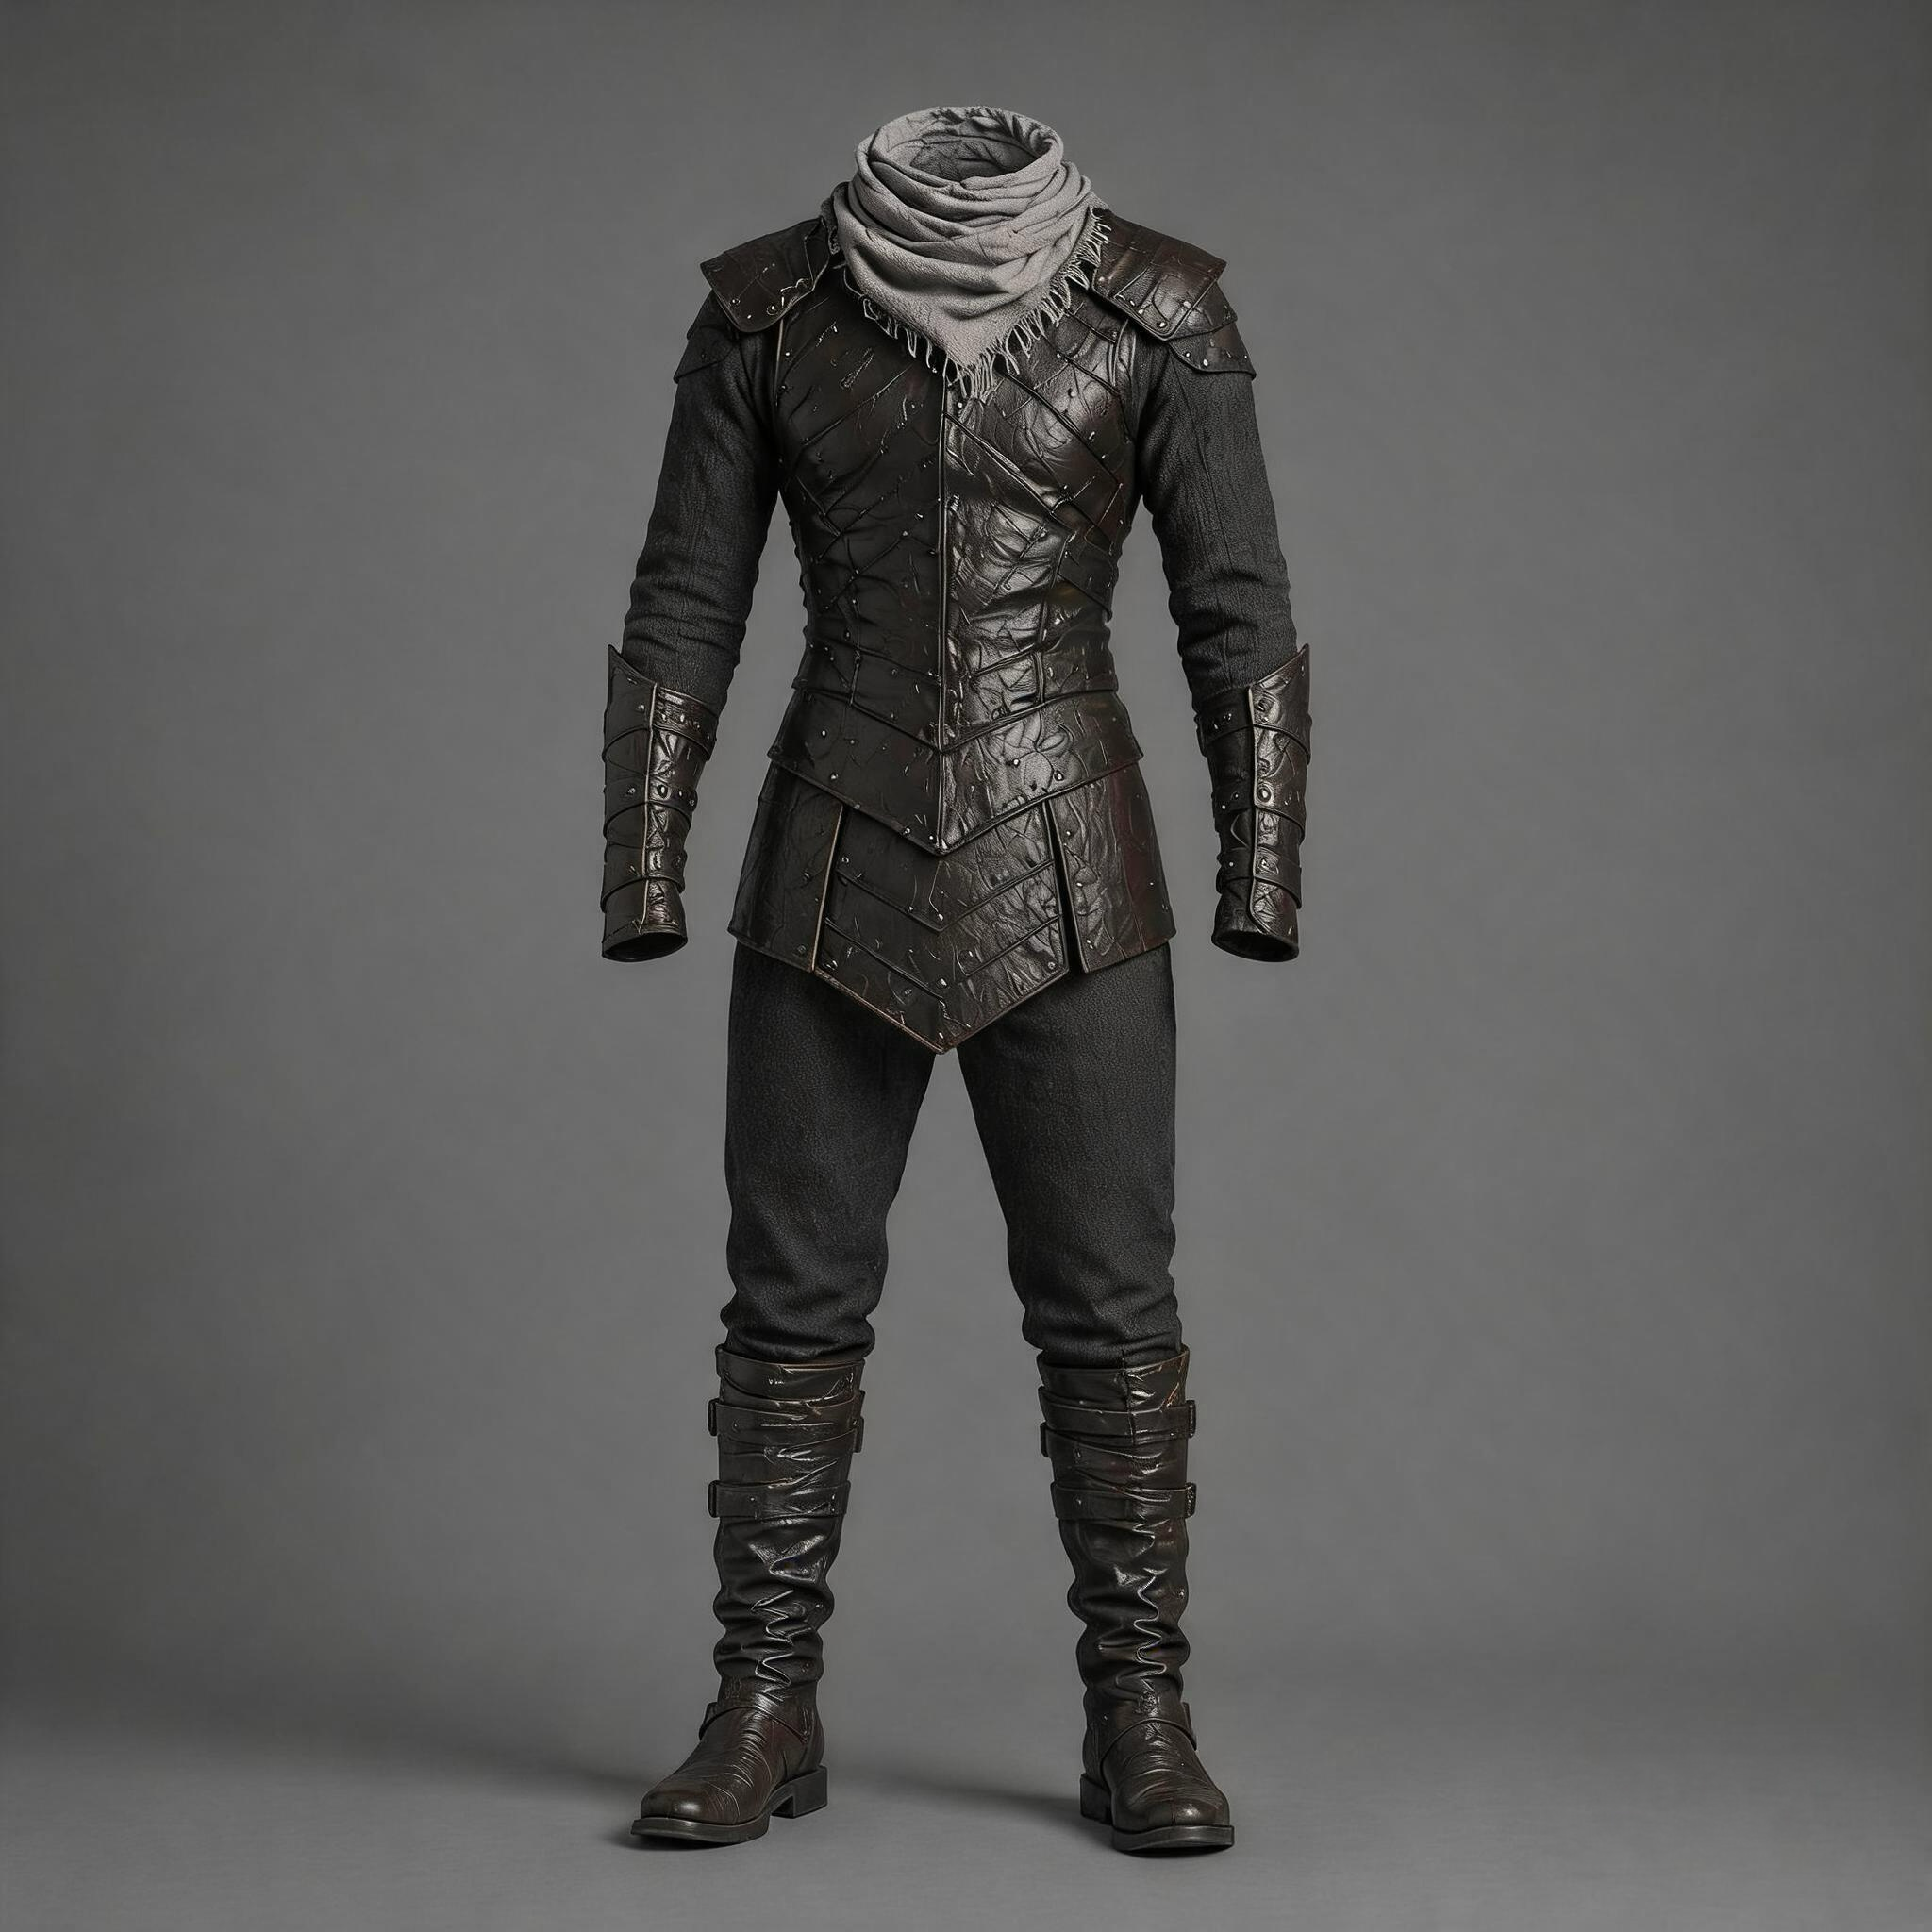图片 3 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 视频 1 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输入:文本 将视频中的人声台词,翻译成中文,无字幕,口型做出对应的精准改变,其余均保持不变。 输入:视频 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 延长任务,生成视频的音量较输入视频可能发生轻微变化;输入 Seedance 2\.5 模型本身生成的视频做延长,音量变化相对较小,无缝衔接的效果更好。 输入:文本 在 @视频 1 的基础上续写 5 秒的视频,讲一只蜜蜂飞来落在画上,接着微距特写蜜蜂腿部和腹部沾满金黄色花粉颗粒,蜜蜂振翅起飞,镜头跟随它飞向另一朵同种花上,慢镜头中,花粉从蜜蜂绒毛上抖落,精准落入花蕊——授粉瞬间被放大。 输出格式选择 MOV 输入:视频 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输出 重播 播放 00:00 / 00:05 直播 进入全屏 进入样式全屏 1x 拼接后的视频: 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输入:文本 将所有图片进行一键成片,图片顺序自由安排,生成一个手绘动态涂鸦抠像风格的咖啡店 vlog,记录一只小狗穿着不同可爱服装在咖啡店打卡拍照的趣味日常。生成具有网感的趣味音频或者 bgm。 图片可以微微动起来,live 图的效果,但不要改变原图,保持和原图的高度一致。 输入:图 图片 1 图片 2 图片 3 输入:图(续) 图片 4 图片 5 图片 6 输入:图(续) 图片 7 图片 8 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 输入:文本 将【视频 1】和【视频 2】衔接起来,【视频 1】的视角急需飞行至顶端快速折返,视角垂直向下俯冲,然后无缝自然地衔接转场到【视频 2】,在镜头切换的过程中麻将牌慢慢变成高楼。整个场景也对应变化,同时不要改变上传的两个视频。 输入:视频 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 视频 1 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x 视频 2 输出 不支持的音频/视频格式 请试试刷新 重播 播放 00:00 / 00:00 直播 进入全屏 进入样式全屏 1x Seedance 2\.0 已经完成了核心生成能力的明显突破,而 Seedance 2\.5 是在此基础上面向真实生产场景做系统性补强:包括更长视频生成、更多素材参考、更稳定的编辑/续写能力,以及在画面宽高比、音画衔接、可控性和工作流适配上的优化。 Seedance 2\.5 的价值不只是「单条视频效果更好」,而是让模型在可复用、可交付、可规模化生产这些关键环节上更进一步。它把 Seedance 从「效果惊艳的创作模型」,继续推进到更接近端到端工业化视频生产的阶段。